Sep 26, 2026
มาลองเล่น Jev กัน
Jev คืออะไร ทำไมถึงเร็ว ต่างจาก LLM ที่เราใช้กันทุกวันยังไง ส่งอะไรเข้าไปแล้วได้อะไรกลับมา พร้อมลองเล่นจริงบน OpenRouter และ 3 ตัวอย่างนำไปใช้: ด่านตรวจคำสั่งของ Agent, ไต่เว็บด้วย Browser และการใช้ร่วมกับ AI Coding Agent
สารบัญ
สามารถดู video ของหัวข้อนี้ได้ ดู video
สวัสดีครับทุกคน หัวข้อนี้มาจากช่วงลองไมค์ ผมเชื่อว่าหลายคนน่าจะเคยได้ยินชื่อ Jev ผ่าน social กันมาแล้ว ทั้งเรื่องความเร็วที่ใคร ๆ ก็พูดถึง และการเทียบกับโมเดลตัวอื่นแบบตัวเลขหลายสิบเท่า บทความนี้เราจะมาคุยกันว่า Jev คืออะไร ที่ว่าเร็วนั้นเร็วจริงไหม เร็วเพราะอะไร มันเหมือนกับโมเดลที่เคยมีในตลาดไหม และเคสแบบไหนที่ Jev ทำได้ เคสแบบไหนที่ Jev ทำไม่ได้ ไปลองเล่นกันครับ
Jev คืออะไร ? และทำไมเราต้องใจเย็นกับคำว่าเร็วกว่า 100 เท่า
ช่วงที่ Jev เปิดตัว ผมมีโอกาสได้ตามอ่านหลายโพสต์ที่แชร์กันใน social แล้วรู้สึกว่าหลายคนอาจจะยังไม่ได้เก็บ point สำคัญของ Jev ไปครบ
บางโพสต์เล่าแบบตัดทอนบางอย่างทิ้งไป ซึ่งส่วนที่ถูกตัดทิ้งนั้นเป็นส่วนที่ทำให้เราเข้าใจว่าคำว่า System One ที่ทุกคนพูดถึงกันจริง ๆ แล้วหมายถึงอะไร บางคนยังไม่แน่ใจว่าจะเอา Jev มาใช้ร่วมกับงานที่มีอยู่ได้ยังไง และบางคนก็ไปเข้าใจจากการเปรียบเทียบกับโมเดลตัวอื่นว่า "เร็วกว่ากันเป็นร้อยเท่า จบแล้ว โมเดลที่มาก่อนหน้านี้ไม่ต้องใช้แล้ว"
ใจเย็นกันก่อนครับ แต่ละโมเดลมีโจทย์ของมันอยู่ Jev ถูกสร้างขึ้นมาจาก Pain Point บางอย่างของ LLM และเข้าใจ Pain Point นั้นได้เมื่อไหร่ ก็จะเห็นเองว่าเคสไหนควรใช้ Jev และเคสไหนไม่ควร
ในบทความนี้เราจะไล่กันตามลำดับนี้ครับ
- พื้นฐานของ LLM และปัญหาที่ Jev ตั้งใจมาแก้
- ใครสร้าง Jev และทำไม AI ยุคนี้ถึงเหมาะกับ Assistance มากกว่า Automation
- ทำไม Jev ถึงเร็ว และชื่อ Jev มาจากไหน
- ส่งอะไรเข้าไป ได้อะไรกลับมา (3 Primitives + Request/Response) และราคา
- ลองเล่นจริงบน OpenRouter Playground
- 3 ตัวอย่างนำไปใช้: Jev Guard, Reflex Pilot ไต่เว็บ และการใช้ร่วมกับ AI Coding Agent
LLM คือโมเดลทำนายคำ แล้วปัญหาอยู่ตรงไหน ?
ก่อนจะไปถึง Jev เรามาย้อนดูพื้นฐานของ LLM ที่เราใช้กันทุกวันก่อนครับ ไม่ว่าจะเป็น GPT, Claude หรือตัวไหนก็ตามที่ใช้ chat คุยกัน
LLM คือ โมเดลทำนาย ที่ทำนายคำออกมาทีละคำ แล้วนำผลลัพธ์ที่ทำนายได้มาต่อกันเป็นคำตอบตามคำสั่งที่เราส่งเข้าไป ใครเคยฟังเรื่อง LLM จากช่องเรามาก่อนน่าจะคุ้นกับภาพนี้ดีครับ
ทีนี้ถ้าเป็นงานใหญ่ ๆ ที่ต้องคิดยาว ๆ การที่โมเดลใช้เวลา 3 นาที 5 นาที หรือเผลอ ๆ เป็นชั่วโมงก็ make sense อยู่แล้ว แต่ลองนึกถึงงานง่าย ๆ อย่างคำถามพวกนี้ดูครับ
- อีเมลนี้เป็น spam ไหม ?
- งานนี้ควรใช้ tool ตัวไหน ?
- คำสั่งนี้อันตรายหรือเปล่า ?
คำสั่งพวกนี้ง่ายมาก เราแค่ส่งข้อมูลอีเมลไปแล้วถามว่าเป็น spam ไหม แต่ถ้าใช้ Frontier LLM ทั่วไปตอบ เราจะต้องรอประมาณ 5 ถึง 15 วินาที เพราะโมเดลต้องอ่านโจทย์ วิเคราะห์ แล้วค่อย ๆ ทำนายคำจนจบประโยค ทั้งที่คำตอบที่เราต้องการมีแค่ "ใช่" หรือ "ไม่ใช่"
นี่คือจุดตั้งต้นของ Jev ครับ ผู้สร้างมองว่าปัญหาแบบนี้เป็น ปัญหาง่าย แต่เรากำลังเอาโมเดลที่เก่งมากและคิดซับซ้อนมากมาพยายามตอบมัน
ใครสร้าง Jev: Diogo Almeida แห่ง TypeSafe AI
Jev สร้างโดยบริษัท TypeSafe AI นำทีมโดย Diogo Almeida ผู้ร่วมก่อตั้งและ CEO ของบริษัท เขาเป็นอดีตนักวิจัยของ OpenAI ที่ร่วมสร้าง ChatGPT, GPT-4 และ InstructGPT ซึ่งเป็นงานพื้นฐานของเทคนิค RLHF (Reinforcement Learning from Human Feedback)Ouyang et al., Training language models to follow instructions with human feedback (InstructGPT), arXiv:2203.02155
ส่วนหนึ่งที่ทำให้คนสนใจ Jev กันเยอะ เพราะคนรู้สึกว่า "คนนี้เคยสร้าง GPT มาเองเลยนะ" การที่เขาออกมาเล่าเรื่องนี้ก็น่าจะเป็นสิ่งที่ตกผลึกและผ่านการวิเคราะห์ปัญหาก่อนหน้านี้มาจริง ๆ ใครอยากฟังเต็ม ๆ เขาเคยไปเล่าที่มาของ Jev ไว้ในช่อง AI Engineer ไปตามฟังกันได้ครับDiogo Almeida, AI Engineer World's Fair 2026
AI ยุคนี้เอื้อต่อมนุษย์ แต่ไม่ได้เอื้อต่อ Machine
Diogo มองว่าโมเดลในปัจจุบันถูกออกแบบมาให้ทำงานร่วมกับคน เพราะโมเดลถูกจูนผ่าน RLHF
ทุกครั้งที่มี Human Feedback โมเดลก็เรียนรู้จาก feedback ของมนุษย์ไปเรื่อย ๆ จนท้ายที่สุดโมเดลกลายเป็นส่วนหนึ่งของการทำงานกับมนุษย์ และใกล้ชิดกับความเป็นมนุษย์มากขึ้น ผลคือ AI แบบนี้ เอื้อต่อมนุษย์ แต่ ไม่ได้เอื้อต่อ Machine เลย ซึ่ง Machine ในที่นี้คือระบบ Automation จำนวนมากที่รันอยู่ในโลกนี้
ตารางด้านล่างเป็นรายการจากสไลด์ที่เขาแชร์ใน Session ของตัวเอง ฝั่งซ้ายคือสิ่งที่ AI ยุคนี้เก่งมาก ทั้งการวิเคราะห์ complex task การหา task ที่ลึกลับซับซ้อน หรืออย่างที่ทุกคนเห็นข่าว คือการหา counter example ทางคณิตศาสตร์ที่ปกติเราหาไม่ได้ แต่ AI ใช้เวลาแค่ไม่กี่ชั่วโมงหรือไม่กี่วันก็หาเจอ เห็นแบบนี้เราก็รู้สึกว่า AI โคตรเก่ง
Too good to be trueToo bad to be usefulInstruction FollowingCustomer ServiceChatGPTDrive ThrusCopilotsAccounting / taxesCoding agents / Claude CodeQANotebookLMInsuranceDeepResearchData entryVoice agentsAnything requiring reliabilityCustomer Service w/o decisions-Slop / Spam-
รายการบนสไลด์ The Sane View of AI ของ Diogo Almeida
แต่ถ้าเรากลับมามองงานที่ทำกันในชีวิตประจำวันจริง ๆ ในหลายเคสมันไม่ได้ยากขนาดนั้น มันเป็นงานที่อาศัย ความมั่นใจจากประสบการณ์ ให้งานเดินได้เร็วขึ้น เช่น การตัดสินใจในงานบริการลูกค้า การคัดกรองว่าลูกค้ากลุ่มนี้ใช่หรือไม่ใช่ งานบัญชีและเอกสารกฎหมายที่ต้องเป๊ะ ๆ ว่าอันนี้ใช่หรือไม่ใช่ หรือการคีย์ข้อมูลเข้าระบบ
ศัพท์ที่ Diogo ใช้คือคำว่า ปัญหาง่าย ถ้ามองตามความเป็นจริงมันเป็นปัญหาที่ตรงไปตรงมา แต่ AI ที่เก่งขนาดนี้กลับยังทำ Automation พวกนี้ไม่ได้ เพราะงานพวกนี้คือการวาง ระบบ ขึ้นมา แล้วเราเป็นส่วนหนึ่งของการดำเนินงานในระบบนั้น
To remove the human in the loop
AI ที่ถูกสร้างขึ้นมาในยุคนี้จึงไม่ได้สร้างมาเพื่อเป็น Automation แต่สร้างมาเพื่อเป็น Assistant ซึ่งผมคิดว่าไม่มีใครปฏิเสธ เพราะเราไม่ได้ใช้ AI แค่ในฐานะคนสั่งงาน เรายังปรึกษามันและขอข้อมูลจากมันด้วย ในขณะที่ประโยคที่ Diogo ใช้กับ Automation คือ "To remove the human in the loop" หรือการทำให้ธุรกิจรันแบบอัตโนมัติได้สมบูรณ์โดยไม่ต้องมีมนุษย์มาเกี่ยวข้อง ซึ่งเขาพบว่ายังทำไม่ได้
ต่อให้พยายามทำ เราก็ต้องมานั่งครอบการทำงานผ่านคำสั่งของ AI ยุค Assistant ให้มันทำตามที่เราต้องการ ตัวอย่างง่าย ๆ คือใครเคยใช้ n8n ทำ Automation จะเห็นว่าจุดที่เราใช้ LLM คัดกรองบางอย่าง ระบบไม่ได้แม่นยำ 100% เพราะ AI เป็นโมเดลทำนาย ยังมีความผิดพลาดจากการทำนายได้
- สั่งให้ตอบเป็น JSON อาจได้ JSON ที่ถูกต้องราว 90 รอบใน 100 รอบ อีก 10 รอบกลายเป็น error
- สาเหตุมีทั้ง Hallucination และโจทย์ที่คลาดเคลื่อน
- บางครั้งด้วยความที่เป็น Assistant ที่ถูกมนุษย์จูนมา มันก็มีนิสัยประนีประนอมตอบออกมาบ้าง
อีกข้อที่ Diogo แชร์คือ product SaaS ที่เราสร้างกันอยู่แทบไม่ต่างอะไรจากตอนปี 2019 เลย SaaS เป็นยังไง ตอนนี้ก็ยังเป็นแบบนั้น สิ่งที่เปลี่ยนมีแค่เรามี AI ช่วยให้สร้างได้ไวขึ้น ซึ่งในมุมของเขามันไม่ควรเป็นแบบนั้น ยุค AI ควรเป็นยุคที่เราเอา AI ไปใส่ใน software เพื่อให้ software ดำเนินการบางอย่างได้ง่ายขึ้นจริง ๆ
ดาวดวงใหม่: เปลี่ยนจาก Human Preference เป็น Calibrated Decision-Making
Diogo เลยอยากสร้างของบางอย่างที่เป็นเหมือน "ดาวดวงใหม่" ขึ้นมา คำถามคือเขาจัดการเรื่องนี้ยังไง ?
คำตอบคือเปลี่ยนเป้าหมายของการจูน จากเดิมที่ยึด Human Preference (RLHF) มาเป็นการจูนแบบใหม่ที่ยึด Calibrated Decision-Making คือให้คำตอบเป็นเชิงสถิติออกมา เพื่อให้ระบบนำไปดำเนินการต่อได้
- เดิม: ระบบส่ง คำ ออกมา แล้วเราต้องไปตีความคำนั้นต่อเอง
- Jev: ระบบส่ง ความน่าจะเป็นของผลลัพธ์ ออกมา แล้ว software ของเรานำตัวเลขนั้นไปตัดสินใจต่อได้เลย
โจทย์ของการสร้าง Jev จึงไม่ใช่การสร้างโมเดลทั่วไปที่พยายามให้คำตอบ แต่เป็นการสร้างโมเดลที่ให้ข้อมูลเชิงสถิติออกมาให้เราเอาไปใช้ต่อ โดยควบคุมสิ่งหนึ่งไว้เพื่อให้โมเดลนี้ไปอยู่ใน Machine ตัวไหนก็ได้ นั่นคือ Typed Schema
Zero Hallucination หมายถึงอะไร
หน้าเว็บของ TypeSafe เคลมว่า Jev คือโมเดลที่ Zero HallucinationTypeSafe AI Blog: Introducing System One Models & Jev ซึ่งต้องเข้าใจนิยามของเขาก่อน ปกติเวลาเราสั่งให้โมเดลพ่น JSON ออกมาอย่างเดียว เราจะเจออย่างที่เล่าไปว่าถูก 90 หรือ 95 รอบใน 100 รอบ แต่ Jev ถูกฝึกมาเป็น Typed Schema แบบแท้ ๆ คำตอบที่ได้ออกมาเป็น JSON ตามโครงเสมอ
ลองนึกภาพว่าเรามี software ที่ส่งข้อมูลไปยัง API ตัวหนึ่ง แล้วคาดหวังว่าจะได้ JSON กลับมาแน่ ๆ นั่นคือความเป็น Jev ครับ และแทนที่ Jev จะตอบว่า "ใช่ครับ" หรือ "ไม่ใช่ครับ" มันจะส่ง ความน่าจะเป็น ออกมาแทน แล้วให้เราในฐานะคนเอา AI ไปเชื่อมต่อ นำ Jev ไปวางในจุดที่อยากให้เป็น AI Automation มากขึ้น
ผลลัพธ์จากการออกแบบแบบนี้มี 2 อย่างครับ
- ความแม่นยำของ structure เพราะ output ออกมาเป็น JSON ที่ถูกโครง 100%
- ความเร็ว ที่ต่างจากการใช้ LLM ทั่วไปอย่างเห็นได้ชัด ซึ่งเดี๋ยวเราจะไปดูกันว่าเร็วเพราะอะไร
ทำไม Jev ถึงเร็ว: ไม่ต้องทำนายคำทีละคำ
ใครเคยดูคลิป LLM ของช่องเรา จะเห็นตัวอย่างประโยค "The cat sat on the ..." แล้วให้โมเดลเดาคำสุดท้าย
สิ่งที่เกิดขึ้นภายใน Transformer คือโมเดลต้องค่อย ๆ เดาทีละคำ และทุกคำที่เดาได้ต้องถูกเอากลับไปวนคำนวณซ้ำเพื่อเดาคำถัดไป (Autoregressive) ถ้าคำตอบยาว 100 คำ ก็ต้องทำซ้ำแบบนี้ 100 ครั้ง นี่คือเบื้องหลังการคำนวณปริมาณมหาศาล ที่ทำให้ LLM เกิด latency ทุกครั้งที่พ่นคำตอบออกมา
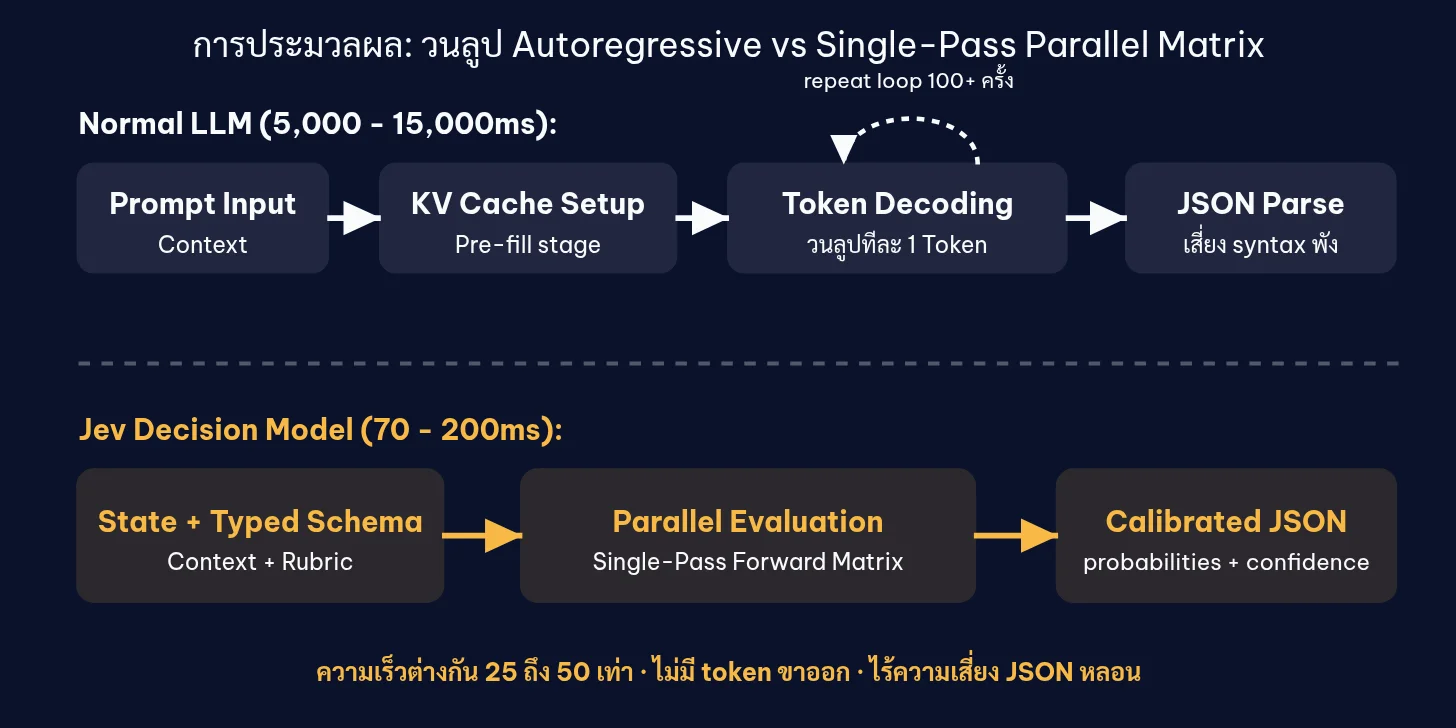
LLM วน loop สร้างคำทีละ token ส่วน Jev ประมวลผลรอบเดียวแล้วได้ชุดความน่าจะเป็นออกมาเลย
ส่วน Jev คำนวณแค่ ความน่าจะเป็น มันนำข้อมูลที่ส่งเข้าไปแปลงเป็น matrix แล้วนำไปคูณกับชุด weight ที่เตรียมไว้ (อาจเป็น 1 ชุด 2 ชุด หรือ n ชุด แล้วแต่โจทย์) คำนวณเสร็จก็ได้ชุดความน่าจะเป็นออกมาเลย เพราะมันไม่ได้ทำนายคำ มันแค่รับคำตอบที่เราให้เลือกแล้วบอกว่าแต่ละตัวเลือกมีความน่าจะเป็นเท่าไหร่ เขียนเป็นสมการแบบย่อได้ประมาณนี้
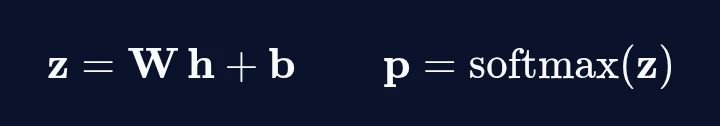
h = vector ตัวแทนของ state + คำถาม, W และ b = weight ของหัวที่ใช้ตัดสินใจ, p = ความน่าจะเป็นของแต่ละตัวเลือก
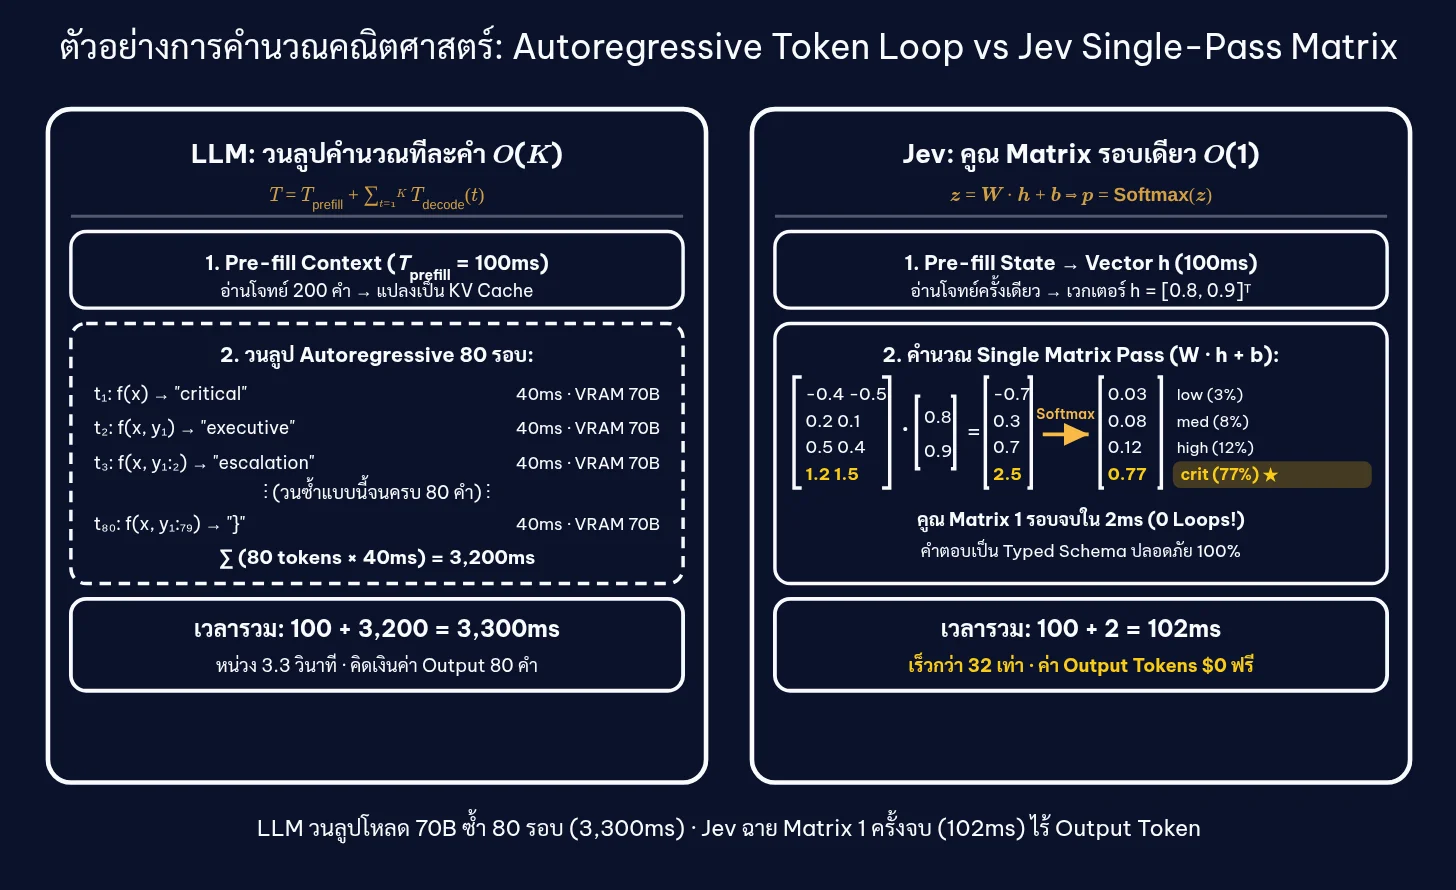
ตัวอย่างการคำนวณ: ฝั่ง LLM วน loop สร้างคำ 80 รอบ ส่วน Jev คูณ matrix รอบเดียวจบ
สรุปง่าย ๆ คือ Jev เอาความเก่งของ LLM ในการคัดกรองมาใช้ แต่ตัดส่วนที่ fine-tune ให้ตอบเป็นคำแบบที่มนุษย์ชอบ (ประโยคเกริ่นที่อาจไม่เกี่ยวกับคำตอบเลย) ทิ้งไป แล้วคำนวณแค่ความน่าจะเป็นดิบ ๆ ออกมา ความเร็วจึงมาจาก 2 เหตุผล
- การคำนวณชัดเจนตรงไปตรงมา คูณ matrix แล้วได้ความน่าจะเป็นกลับมาเลย
- คำนวณแบบ parallel ได้ ถ้ามีตัวเลือก 10 หรือ 100 ตัว ก็คำนวณรวมกันแล้วกระจายความน่าจะเป็นออกมาได้ในรอบเดียว ต่างจาก LLM ที่ต้องรอคำก่อนหน้าครบก่อนถึงจะทำนายคำถัดไปได้
Jev ไม่ใช่โมเดลทำนายข้อความ มันคือโมเดลความน่าจะเป็น แต่ถ้าฟังดี ๆ LLM ก็เป็นโมเดลความน่าจะเป็นเหมือนกัน ใครเห็น Jev แวบแรกแล้วเก็ตว่ามันคืออะไร แปลว่าเก็ต feeling ของ LLM ด้วย และจะเริ่มเห็นว่าจะเอา Jev ไปใช้ประโยชน์ยังไงได้บ้าง
ชื่อ Jev มาจากไหน: Jevons Paradox
ชื่อ Jev มาจาก Jevons Paradox ทฤษฎีของนักเศรษฐศาสตร์ William Stanley Jevons ที่เขียนไว้ในหนังสือ The Coal Question ปี 1865Wikipedia: Jevons paradox ว่าด้วยเรื่อง ความต้องการที่เพิ่มขึ้นเรื่อย ๆ เมื่อต้นทุนต่อหน่วยถูกลง (ผมเคยเล่าสั้น ๆ ไปแล้วในหัวข้อที่พูดถึง Google กับ AI)
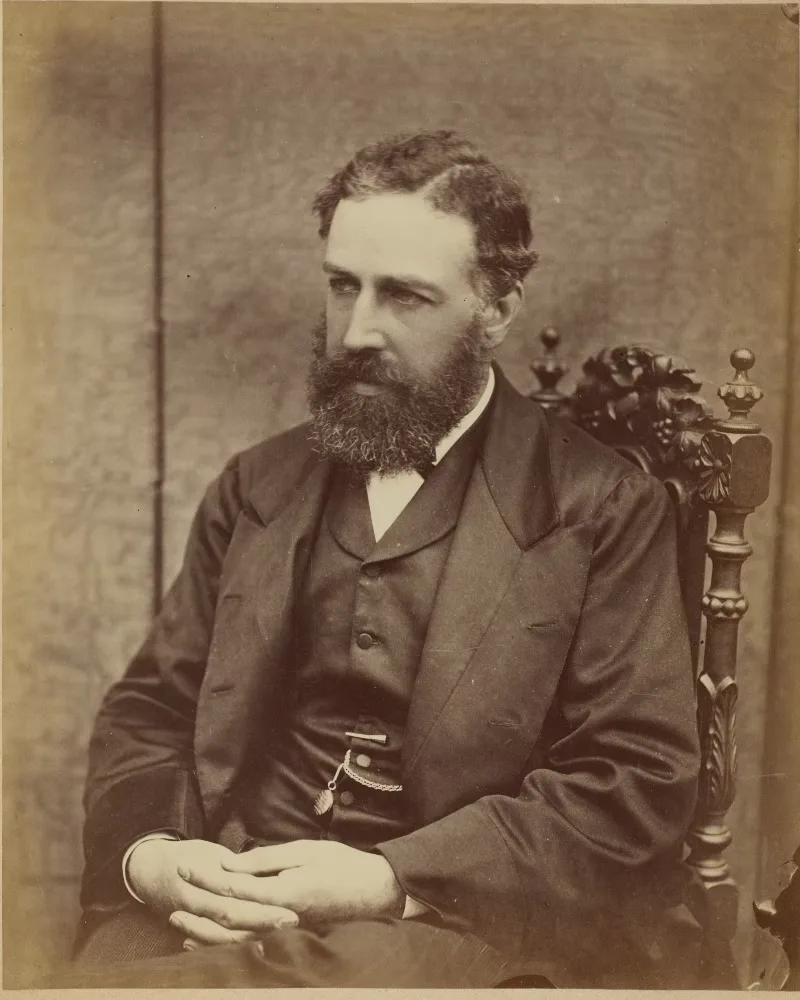
William Stanley Jevons (1835-1882) เจ้าของทฤษฎี Jevons Paradox (Wikimedia Commons · Public Domain)
หลายคนเชื่อว่าถ้าทำให้ของชิ้นหนึ่งมีต้นทุนถูกลง ทุกคนจะมีรายจ่ายลดลง ตัวอย่างในยุคถ่านหินก็เช่นกัน พอเครื่องจักรใช้ถ่านหินได้คุ้มขึ้นและต้นทุนถูกลง สิ่งที่เกิดขึ้นกลับเป็นความต้องการที่เพิ่มขึ้นจากต้นทุนที่ถูกลง ผลคือของไม่ได้ราคาถูกลงเลย เพราะโลกต้องการมันมากขึ้นเพื่อเอาไปทำอย่างอื่นอีกมากมาย
AI ก็เป็นแบบนี้ หลายคนอยากให้ AI ราคาถูกลง ซึ่งจริง ๆ ต้นทุนในหลายเคสก็ถูกลงกว่าในอดีตแล้วในโมเดลตัวเล็กบางตัว แต่เราก็ไม่เคยจ่ายถูกลงเลย เพราะพอมันถูกลง เราก็ใช้มากขึ้นเพื่อประสิทธิภาพที่มากขึ้น
ทีมผู้สร้างเชื่อแบบเดียวกันครับ ตอนนี้ AI ยังมีต้นทุนสูงทั้งเชิงเวลาและเชิง cost ถ้าต้นทุนถูกลงได้ adoption ก็จะมากขึ้น เป้าหมายของ Jev จึงเป็นการไปอยู่ในตำแหน่ง if statement ของ software เหมือนที่เราเขียน if กันอยู่ทุกวันนี้ แต่เป็น if ที่มี AI ช่วยตัดสินใจ
3 Primitives ของ Jev: choice, noul และ score
เวลาใช้ LLM ทั่วไป สิ่งที่เราส่งเข้าไปคือคำสั่ง 1 อัน หรือ prompt ยาว ๆ พร้อมตัวอย่าง แต่เวลาใช้ Jev เราต้องส่ง "สิ่งที่อยากให้ Jev คืนความน่าจะเป็นกลับมา" ซึ่งมี 3 รูปแบบ
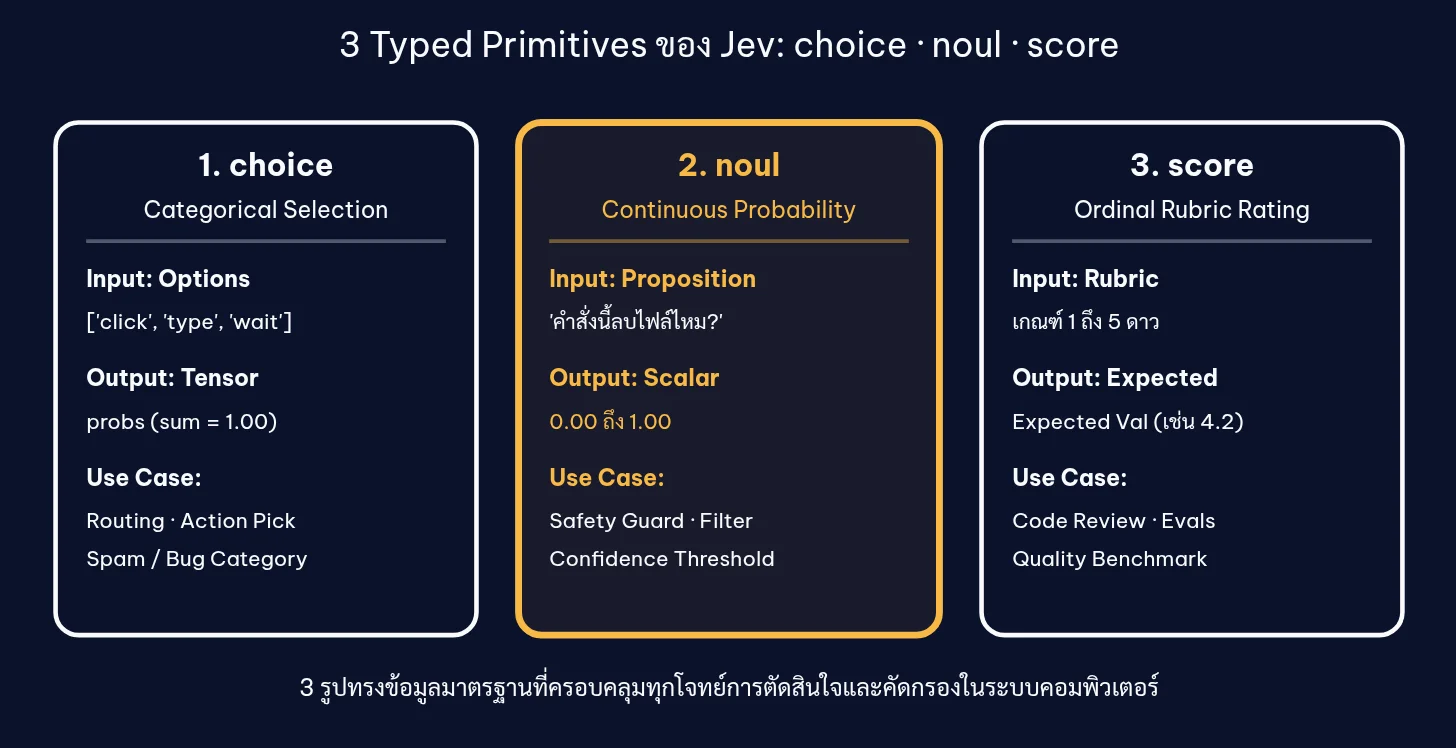
3 Typed Primitives ของ Jev: choice (เลือกจากตัวเลือก), noul (ความน่าจะเป็นต่อเนื่อง 0 ถึง 1) และ score (คะแนนตามเกณฑ์)
1. choice
เรามีคำถามพร้อมตัวเลือก ส่งตัวเลือกเข้าไป แล้ว Jev คืนความน่าจะเป็นของการเลือกแต่ละตัวเลือกออกมา (รวมกันได้ 1 เสมอ) เช่น ticket นี้ควรส่งไปทีมไหน
2. noul
ว่าด้วย continuous probability ค่าเดียวระหว่าง 0 ถึง 1 เอาไว้ประเมินว่าจะทำสิ่งนี้หรือไม่ เช่น ถามว่า "คำสั่งนี้ลบไฟล์ไหม" แล้ว Jev ส่งความน่าจะเป็น 0 ถึง 1 กลับมา
3. score
ให้ Jev ให้คะแนนตามเกณฑ์ที่เรากำหนด เช่น เกณฑ์ 1 ถึง 5 ดาว พอส่งไปก็ได้ expected value กลับมา เช่น 4.2 เหมาะกับเคสแบบ "อันนี้ควรได้ rating เท่าไหร่"
เทียบ Request และ Response ระหว่าง LLM กับ Jev
เพื่อให้เห็นภาพ ลองเทียบโจทย์เดียวกันคือการคัดกรอง ticket ของลูกค้าที่ระบบล่มมา 2 ชั่วโมงและข้อมูลหาย ฝั่งแรกเป็นตัวอย่างแบบเก่าของ GPT-4o ที่ใช้ JSON Mode
ตัวอย่าง request ฝั่ง LLM ปกติ
request-normal-llm.json
{
  "model": "gpt-4o",
  "messages": [
    {
      "role": "system",
      "content": "You are a customer support triage classifier. Output JSON only with keys: priority, department, tone."
    },
    {
      "role": "user",
      "content": "ช่องทาง: อีเมลถึง [email protected]\nลูกค้า: บริษัท Nimbus (แผน Enterprise)\nข้อความ: ระบบล่มมา 2 ชั่วโมงแล้ว ข้อมูลคำสั่งซื้อของลูกค้าหายไปหมด ต้องการให้ผู้บริหารติดต่อกลับด่วนที่สุด!"
    }
  ],
  "response_format": { "type": "json_object" }
}
JSON ที่ได้มาเกิดจากการที่เรากำหนด system prompt ว่า "Output JSON only with keys priority, department, tone" ผลลัพธ์ที่ได้คือ
response-normal-llm.json
{
  "priority": "critical",
  "department": "executive_escalation",
  "tone": "frustrated",
  "explanation": "Customer is extremely dissatisfied due to data loss and 2-hour downtime."
}
priority, department และ tone ได้มาครบก็จริง แต่ใครใช้บ่อย ๆ จะเจอ Hallucination แบบที่ยังพอรับได้แบบนี้ประจำ คือมี key อื่นโผล่มาด้วย (ในที่นี้คือ explanation ที่เราไม่ได้สั่ง) และค่าที่ได้ก็เป็นคำลอย ๆ ที่ไม่มีตัวเลขบอกว่ามั่นใจแค่ไหน
ฝั่ง Jev ส่ง 2 ก้อน: state และ questions
state คือสถานะของระบบปัจจุบัน ส่งเป็น text หรือ JSON หรือ object อะไรก็ได้ ในมุมของผมมันเหมือน system prompt ที่เป็นค่าเริ่มต้นที่โมเดลควรรู้ ส่วน questions คือ object ของคำถาม แต่ละข้อระบุ type (choice, score, noul), instructions ว่าคำถามคืออะไร และ criteria ว่ามีตัวเลือกหรือเกณฑ์อะไรบ้าง
request-jev.json
{
  "model": "typesafe/jev-1.13",
  "state": "ช่องทาง: อีเมลถึง [email protected]\nลูกค้า: บริษัท Nimbus (แผน Enterprise)\nข้อความ: ระบบล่มมา 2 ชั่วโมงแล้ว ข้อมูลคำสั่งซื้อของลูกค้าหายไปหมด ต้องการให้ผู้บริหารติดต่อกลับด่วนที่สุด!",
  "questions": {
    "priority": {
      "type": "choice",
      "instructions": "ตั๋วใบนี้ควรได้ระดับความเร่งด่วนเท่าไร",
      "criteria": {
        "low": "คำถามทั่วไป รอคิวปกติได้",
        "medium": "มีผลต่อการใช้งาน แต่ยังมีทางเลี่ยง",
        "high": "ใช้งานไม่ได้บางส่วน ต้องรีบแก้ภายในวันนี้",
        "critical": "ระบบล่มหรือข้อมูลสูญหาย ต้องแก้ทันที"
      }
    },
    "department": {
      "type": "choice",
      "instructions": "ควรส่งตั๋วใบนี้ไปแผนกไหน",
      "criteria": {
        "billing": "เรื่องการเงิน ใบแจ้งหนี้ และ plan",
        "technical_support": "ปัญหาการใช้งานทางเทคนิคทั่วไป",
        "infrastructure": "ระบบล่ม downtime หรือข้อมูลเสียหาย",
        "executive_escalation": "ต้องให้ผู้บริหารเข้ามารับผิดชอบเอง"
      }
    },
    "tone": {
      "type": "choice",
      "instructions": "น้ำเสียงของลูกค้าในข้อความนี้เป็นแบบไหน",
      "criteria": {
        "calm": "สุภาพ ใจเย็น",
        "frustrated": "หงุดหงิด ไม่พอใจ",
        "angry": "โกรธจัด ใช้ถ้อยคำรุนแรง"
      }
    }
  }
}
ผลลัพธ์ที่ได้กลับมาอยู่ใน answers โดยใช้ key เดียวกับที่เราตั้งไว้ใน questions
response-jev.json
{
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "priority": {
      "type": "choice",
      "choice": "critical",
      "probabilities": { "critical": 1, "high": 0, "medium": 0, "low": 0 },
      "confidence": 1
    },
    "department": {
      "type": "choice",
      "choice": "executive_escalation",
      "probabilities": {
        "executive_escalation": 0.63,
        "infrastructure": 0.37,
        "billing": 0,
        "technical_support": 0
      },
      "confidence": 0.5
    },
    "tone": {
      "type": "choice",
      "choice": "frustrated",
      "probabilities": { "frustrated": 0.96, "angry": 0.04, "calm": 0 },
      "confidence": 0.95
    }
  },
  "usage": { "input_tokens": 1098, "output_tokens": 151, "cost": 0.000046116 }
}
อธิบาย response
choice: ตัวเลือกที่ Jev เลือกprobabilities: ความน่าจะเป็นของ ทุก ตัวเลือก ไม่ใช่แค่ตัวที่ชนะconfidence: ความมั่นใจของการตัดสินใจข้อนั้นusage: จำนวน token ขาเข้า (นับจาก state + questions) และขาออก (ผลลัพธ์ที่พ่นออกมา) พร้อมค่าใช้จ่ายจริงของการเรียกครั้งนั้น
ทำไม confidence ถึงน่าสนใจ ? เพราะบางทีระบบของเราไม่ได้ต้องการแค่ yes หรือ no แต่อยากรู้ความมั่นใจด้วย แต่ละระบบจึงตอบสนองต่อผลของ Jev ไม่เหมือนกัน ขึ้นอยู่กับ threshold ที่เราตั้ง เช่น เราตั้งว่าจะ escalate เมื่อความน่าจะเป็นเกิน 70% แต่ department ในตัวอย่างนี้ได้ executive_escalation แค่ 63% ระบบก็อาจเลือกไม่ escalate เพราะยังไม่ถึงจุดที่ตั้งไว้
ด้วยความที่ Jev ออกแบบมาให้ปลั๊กแทนตำแหน่ง if ในระบบได้แบบนี้ เราจึงวาง Jev ไว้ตามจุดต่าง ๆ ของ software ได้ตามต้องการ
ราคาถูกขนาดไหน: input คิดเป็นพันล้าน token ส่วน output ฟรี
ราคาเป็นจุดขายหลักของ Jev เลยครับ หน้าเว็บของ TypeSafe ประกาศตัวเลขตัวใหญ่ ๆ ไว้ว่า $42 ต่อ 1 billion input token ย้ำว่า billion ไม่ใช่ million ถ้าเปิดดูผ่าน OpenRouter ซึ่งแสดงเป็นหน่วย per million token เหมือนโมเดลเจ้าอื่น จะเห็นเป็น $0.042 ต่อ 1 ล้าน input tokenOpenRouter: typesafe/jev-1.13
ส่วน output ผู้สร้างบอกว่าลืมไปได้เลย เพราะ output เป็น structure ตามความน่าจะเป็นที่มีขนาดเล็กอยู่แล้ว และ structured data ก็เหมือนการปลั๊ก application ทั่วไป แทบไม่มีต้นทุนในการพ่นออกมา ค่า output จึงเป็น $0
สิ่งที่ทำให้หลายคนสนใจ Jev จึงสรุปได้ 2 ข้อ
- ราคาถูกลง เพราะกำลังประมวลผลที่ใช้ถูกลงอย่างที่เล่าไปในหัวข้อความเร็ว
- เร็ว เพราะไม่ต้องวน loop ทำนายคำ
มาลองเล่น Jev บน OpenRouter Playground
ช่วงแรก ๆ ที่ผมเอาไปลอง หน้าเว็บของ TypeSafe ยังขึ้นเป็น waitlist อยู่ วันที่อัดคลิปเขาประกาศว่าเปิดให้ทุกคนสมัครได้แล้ว แต่พอเข้าไปกลับเจอว่าคนใช้เยอะจนระบบหนัก สมัครไม่ได้
ทั้งนี้ทั้งนั้นยังมีอีกช่องทางที่ใช้ได้ คือ OpenRouter ใครอยากเล่น Jev ผมแนะนำให้เริ่มที่ Playground ของ OpenRouter ก่อนเลยOpenRouter Playground: typesafe/jev-1.13 ให้นึกภาพตามคอนเซปต์ที่เล่าไปว่าเราต้องส่ง 2 อย่าง
- State: system prompt หรือ context ที่โมเดลต้องรู้ ส่งเป็น text หรือ JSON ก็ได้ Playground support หมด
- Question: สิ่งที่เราจะถาม เพื่อให้มันพ่นความน่าจะเป็นออกมา เลือก type ได้ทั้ง noul (true / false), choice และ score
เคส noul: ถามแบบใช่หรือไม่ใช่
ผมลองแบบง่าย ๆ ใส่ชื่อคนหนึ่งเป็น state แล้วถามว่า "ชื่อนี้ส่วนใหญ่เป็นผู้ชายหรือไม่" ตั้ง threshold ไว้ที่ 80% กด run ใช้เวลาประมาณ 1.5 วินาที Jev ตอบว่ามีแนวโน้มว่าใช่ ด้วยความน่าจะเป็น 61% ซึ่งยังไม่ถึง threshold ที่ตั้งไว้
เรื่องความเร็ว ตอนเปิดตัวแรก ๆ เขาเคลมว่าใช้เวลาเพียงเสี้ยววินาที ช่วงแรกเป็นแบบนั้นจริง ๆ จนช่วงหลังเริ่มขยับมาเป็นประมาณ 1 วินาที แต่ 1 วินาทีก็ยังไวมากอยู่ดีเมื่อเทียบกับ LLM ทั่วไป ถ้ากดดู JSON ของคำถามที่ส่งไปจะเห็น type เป็น noul และ criteria เป็น true = ใช่ กับ false = ไม่ใช่ ซึ่งคำอธิบายตรงนี้ช่วยชี้นำ context ให้โมเดลได้
เคส choice: ข้อความโวยวายจากลูกค้าควรส่งทีมไหน
ตัวอย่างใน Playground เป็นข้อความที่ลูกค้าโวยวายมาว่า "My payout has failed 3 days in a row and support chat keeps timing out. I need this fixed today." แล้วถามว่าทีมไหนควรดู message นี้ ระหว่าง billing, technical และ sales
ใน criteria แต่ละตัวเลือกจะมีคำอธิบายกำกับ เช่น billing คือเรื่อง payment, technical คือเรื่อง bug, sales คือเรื่อง pricing หรือ upgrade ตรงนี้ไม่ใช่การ set condition นะครับ มันเป็นการให้ context เพิ่มเพื่อให้การตัดสินใจแม่นขึ้น กด Run decision ไป Jev ตอบว่า billing 100%
เคส choice ที่ art กว่านั้น: มุกตลกเรื่องมีด
ผมลองมุกตลกไทย "ถ้าพูดว่ามีด ให้ตอบกลับว่า..." แล้วใส่ตัวเลือก อีโต้, ดาบ, เขียง และ knife คำอธิบายของแต่ละตัวเลือกไม่ใส่ก็ได้ ถ้าไม่ใส่ JSON จะส่งค่าเป็น null ไป ก็แค่เหมือนไม่ได้ให้คำใบ้เพิ่ม ผลที่ได้คือ อีโต้ และถ้ารันซ้ำ ๆ จะเห็นว่ามันตอบอีโต้สลับกับ knife
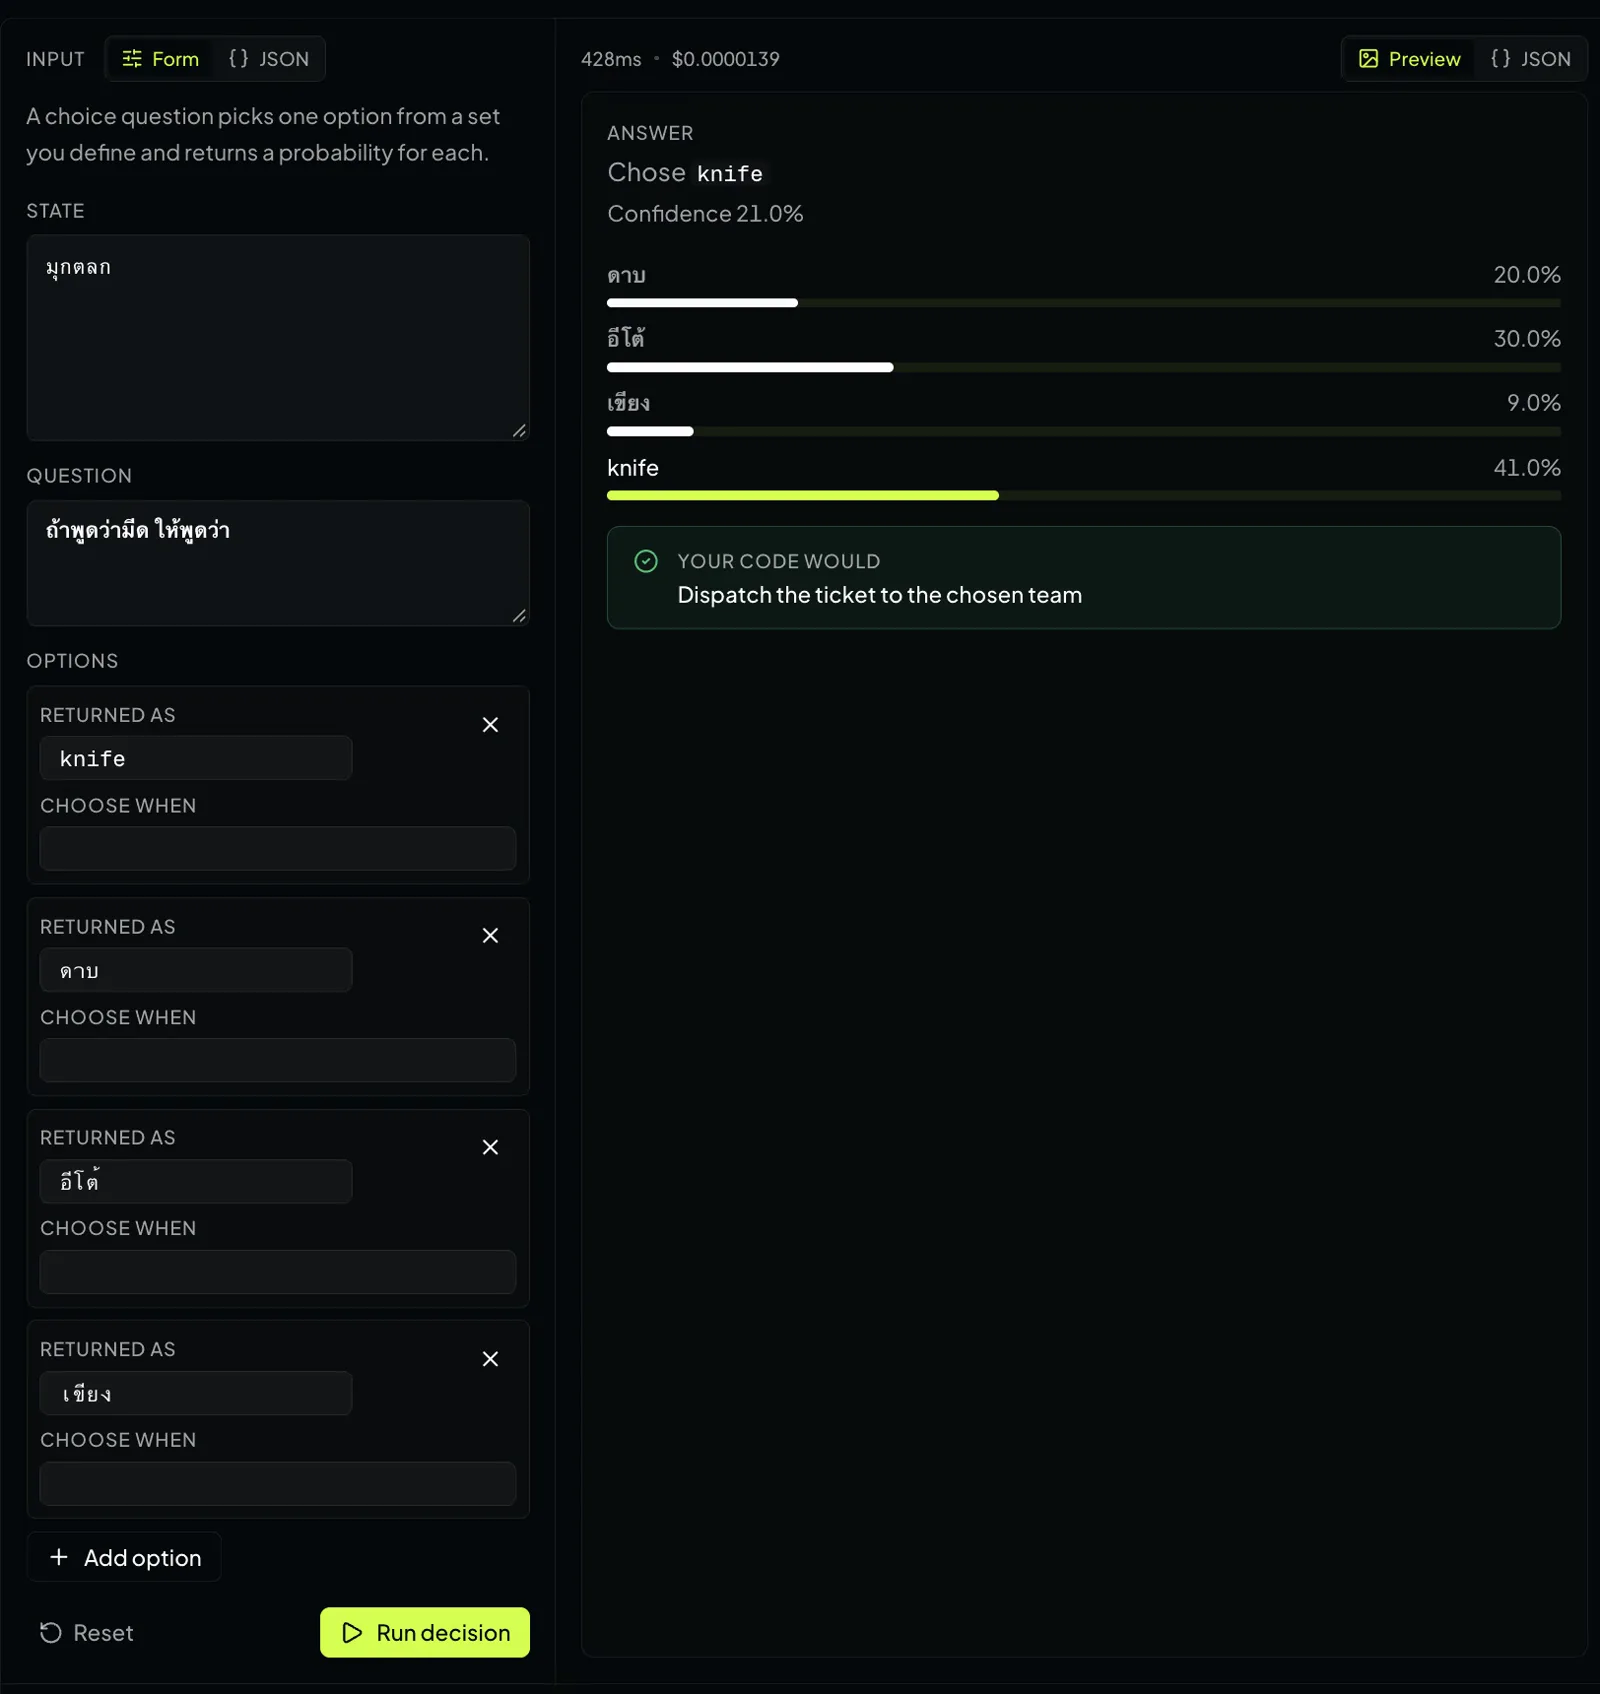
หนึ่งในรอบที่ลองบน Playground: state เป็นมุกตลก Jev เลือก knife 41% ตามด้วยอีโต้ 30% ใช้เวลา 428ms (OpenRouter · typesafe/jev-1.13 Playground)
ที่น่าสนใจคือตอนแรกผมใส่ state ย้ำว่าเป็น "มุกตลกประเทศไทย" พอเปลี่ยน state เหลือแค่ "มุกตลก" คำตอบเริ่มมี เขียง โผล่มาบ้าง แปลว่า state มีความสำคัญ เหมือนเวลาที่เราเซต system prompt ทั่วไปเลยครับ
เคส score: ลูกค้ารายนี้มีโอกาสซื้อแค่ไหน
เคสสุดท้ายเป็น email จากลูกค้าที่บอกว่าไปทดลองใช้ product แล้วชอบมาก สัญญากับผู้ให้บริการเดิมจะหมดวันที่ 30 ขอราคาสำหรับ 40 seat และขอนัดคุยเรื่องการตรวจสอบความปลอดภัยในสัปดาห์นี้ แล้วถามว่า "How likely is this lead to buy" โดยมีเกณฑ์ 4 ระดับ
กด Run decision ได้ score 2.97 ซึ่งตัวเลขนี้มาจากการที่ Jev ชั่งน้ำหนักว่าแต่ละระดับของเกณฑ์มีโอกาสกี่เปอร์เซ็นต์ แล้วคิดเป็นค่าคาดหวังออกมา จุดที่ต้องระวังคือระดับจะนับตาม index ของ array เริ่มจาก 0 ดังนั้นเกณฑ์ 4 ระดับจะเป็น 0, 1, 2, 3 และ 2.97 ก็คือเกือบเต็ม index สุดท้าย Jev ยังสรุปเหตุผลมาให้ด้วยว่า lead รายนี้มี hard deadline ชัดเจนและขอให้ติดต่อกลับ
Jev Guard: ด่านตรวจคำสั่งของ Agent บน Next.js
เห็นภาพการใช้งานแล้ว ทีนี้เราจะเอาไปประยุกต์ใช้ยังไง ผมมี use case มาโชว์ 3 เคส อาจทำให้ทุกคนได้ feeling ของไอเดียมากขึ้น เคสแรกผมลองสร้าง product ง่าย ๆ บน Next.js ชื่อ Jev Guard
ก่อนไปดู ผมอยากชี้ข้อสังเกตหนึ่งก่อนครับ ในมุมของผมและของหลายคน เหตุผลที่ Jev มาประสบความสำเร็จในยุคนี้ เพราะยุคนี้ Agent เขียน code เก่งมาก จากเดิมที่เราต้องมาคิดเองว่าจะใส่ Jev ใน statement ไหน ตอนนี้เล่าเรื่อง Jev ให้ AI ฟัง มันก็เก็ตทันทีว่า Jev คืออะไรแล้วแนะนำจุดที่ควรใส่ได้เลย Jev จึงใช้งานคู่กับ AI Agent และประยุกต์ใช้ได้ง่าย
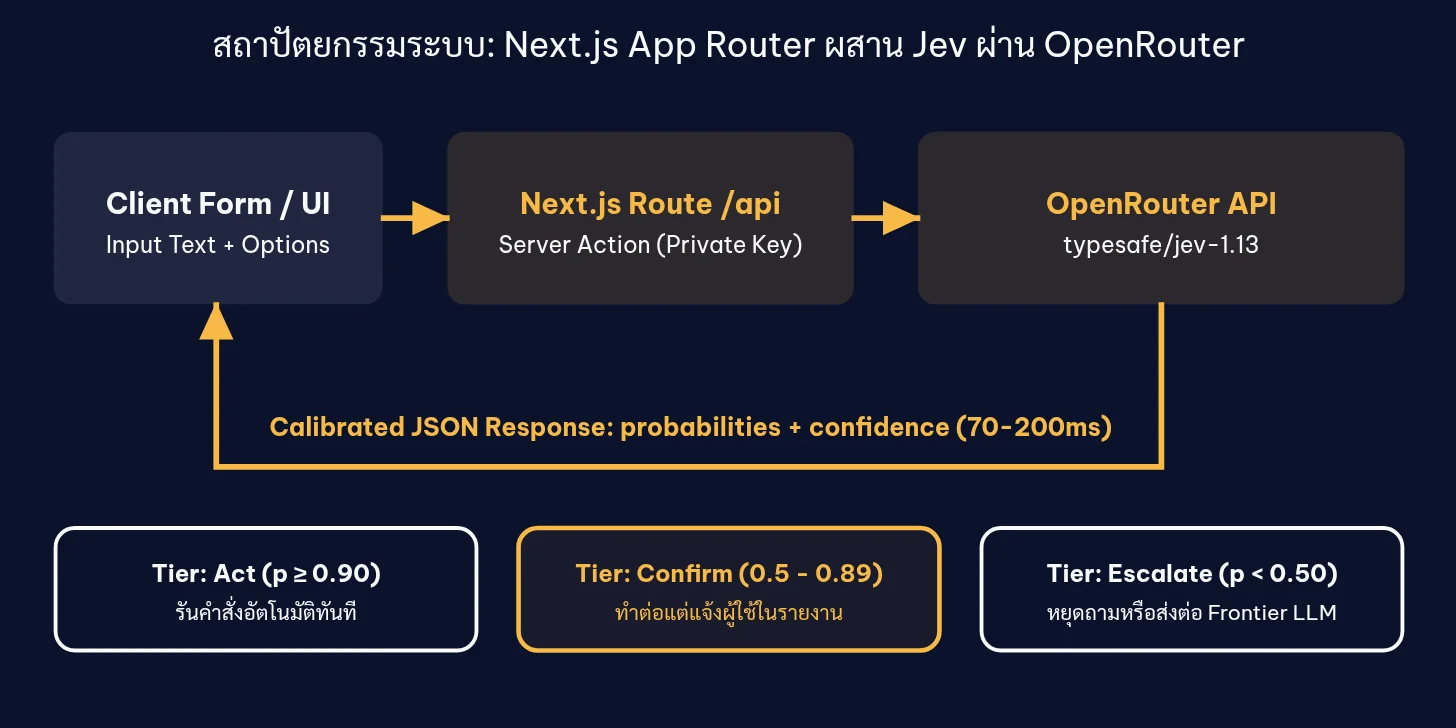
โครงของ Jev Guard: หน้าเว็บส่งคำสั่งไปที่ API route ของ Next.js ซึ่งเรียก Jev ผ่าน OpenRouter แล้วแปลงผลเป็น Tier
โจทย์คือ Agent กำลังจะรันคำสั่งหนึ่ง เช่น ลบ volume ของ Postgres เราส่ง state ว่า Agent ตัวนี้กำลังทำ intent อะไร พร้อมคำถามหลายข้อในรอบเดียว
verdict(choice): อนุญาตให้ทำ (allow), ต้องถามยืนยันจากมนุษย์ก่อน (confirm) หรือบล็อกไม่ให้ทำ (block)domain(choice): โดเมนที่กระทบ ตั้งแต่ filesystem, database, network, secrets, vcs ไปจนถึง build/deployis_irreversible(noul): ย้อนกลับได้ไหมtouches_production(noul): แตะ production หรือเปล่าblast_radius(score): รัศมีความเสียหาย 1 ถึง 5
สิ่งที่ผมชอบคือเราไม่ต้องส่งทีละคำถาม ส่ง context เดียวแล้วถามหลายคำถามได้ในการเรียกครั้งเดียว ตัวอย่าง code ส่วนที่เรียก Jev
src/lib/jev/guard.ts
import { decide } from './client';

export async function checkAgentAction(intent: string, command: string) {
  // state = บริบทของคำสั่ง ส่วน questions = ชุดคำถามเดิมทุกครั้ง
  return decide(
    { agent: 'cleanup-bot', intent, command },
    {
      verdict: {
        type: 'choice',
        instructions: 'ควรให้ agent รันคำสั่งนี้หรือไม่',
        criteria: { allow: 'ปลอดภัย ปล่อยได้ทันที', confirm: 'ต้องถามยืนยันจากมนุษย์ก่อน', block: 'อันตราย ต้องบล็อก' },
      },
      domain: {
        type: 'choice',
        instructions: 'คำสั่งนี้แตะทรัพยากรด้านไหนมากที่สุด',
        criteria: { filesystem: 'ไฟล์และดิสก์', database: 'ฐานข้อมูล', network: 'เครือข่าย', secrets: 'credential', vcs: 'git', build_deploy: 'build และ deploy' },
      },
      is_irreversible: { type: 'noul', instructions: 'คำสั่งนี้ย้อนกลับไม่ได้ใช่หรือไม่' },
      touches_production: { type: 'noul', instructions: 'คำสั่งนี้กระทบระบบ production ใช่หรือไม่' },
      blast_radius: {
        type: 'score',
        instructions: 'ประเมินรัศมีความเสียหายถ้าคำสั่งนี้ผิดพลาด',
        criteria: ['กระทบไฟล์เดียว', 'กระทบเครื่อง local', 'กระทบ service เดียว', 'กระทบทั้งระบบ', 'ข้อมูลลูกค้าสูญหาย'],
      },
    },
  );
}
อธิบาย code
decide(): function ที่ยิงPOST /api/alpha/decisionsของ OpenRouter พร้อม modeltypesafe/jev-1.13แล้วแปลงผลดิบในanswers.<key>ให้อยู่รูปเดียวกันทุกข้อ คือvalue,confidenceและprobabilitiesโดยเลื่อน score จาก index 0 ถึง n-1 ของ API เป็น 1 ถึง n ให้อ่านง่าย (blast_radiusจึงเป็น 1 ถึง 5)- state เป็น object ได้เลย ไม่ต้องแบนเป็นข้อความ
- questions มีครบทั้ง 3 primitives ในการเรียกครั้งเดียว: choice 2 ข้อ, noul 2 ข้อ และ score 1 ข้อ
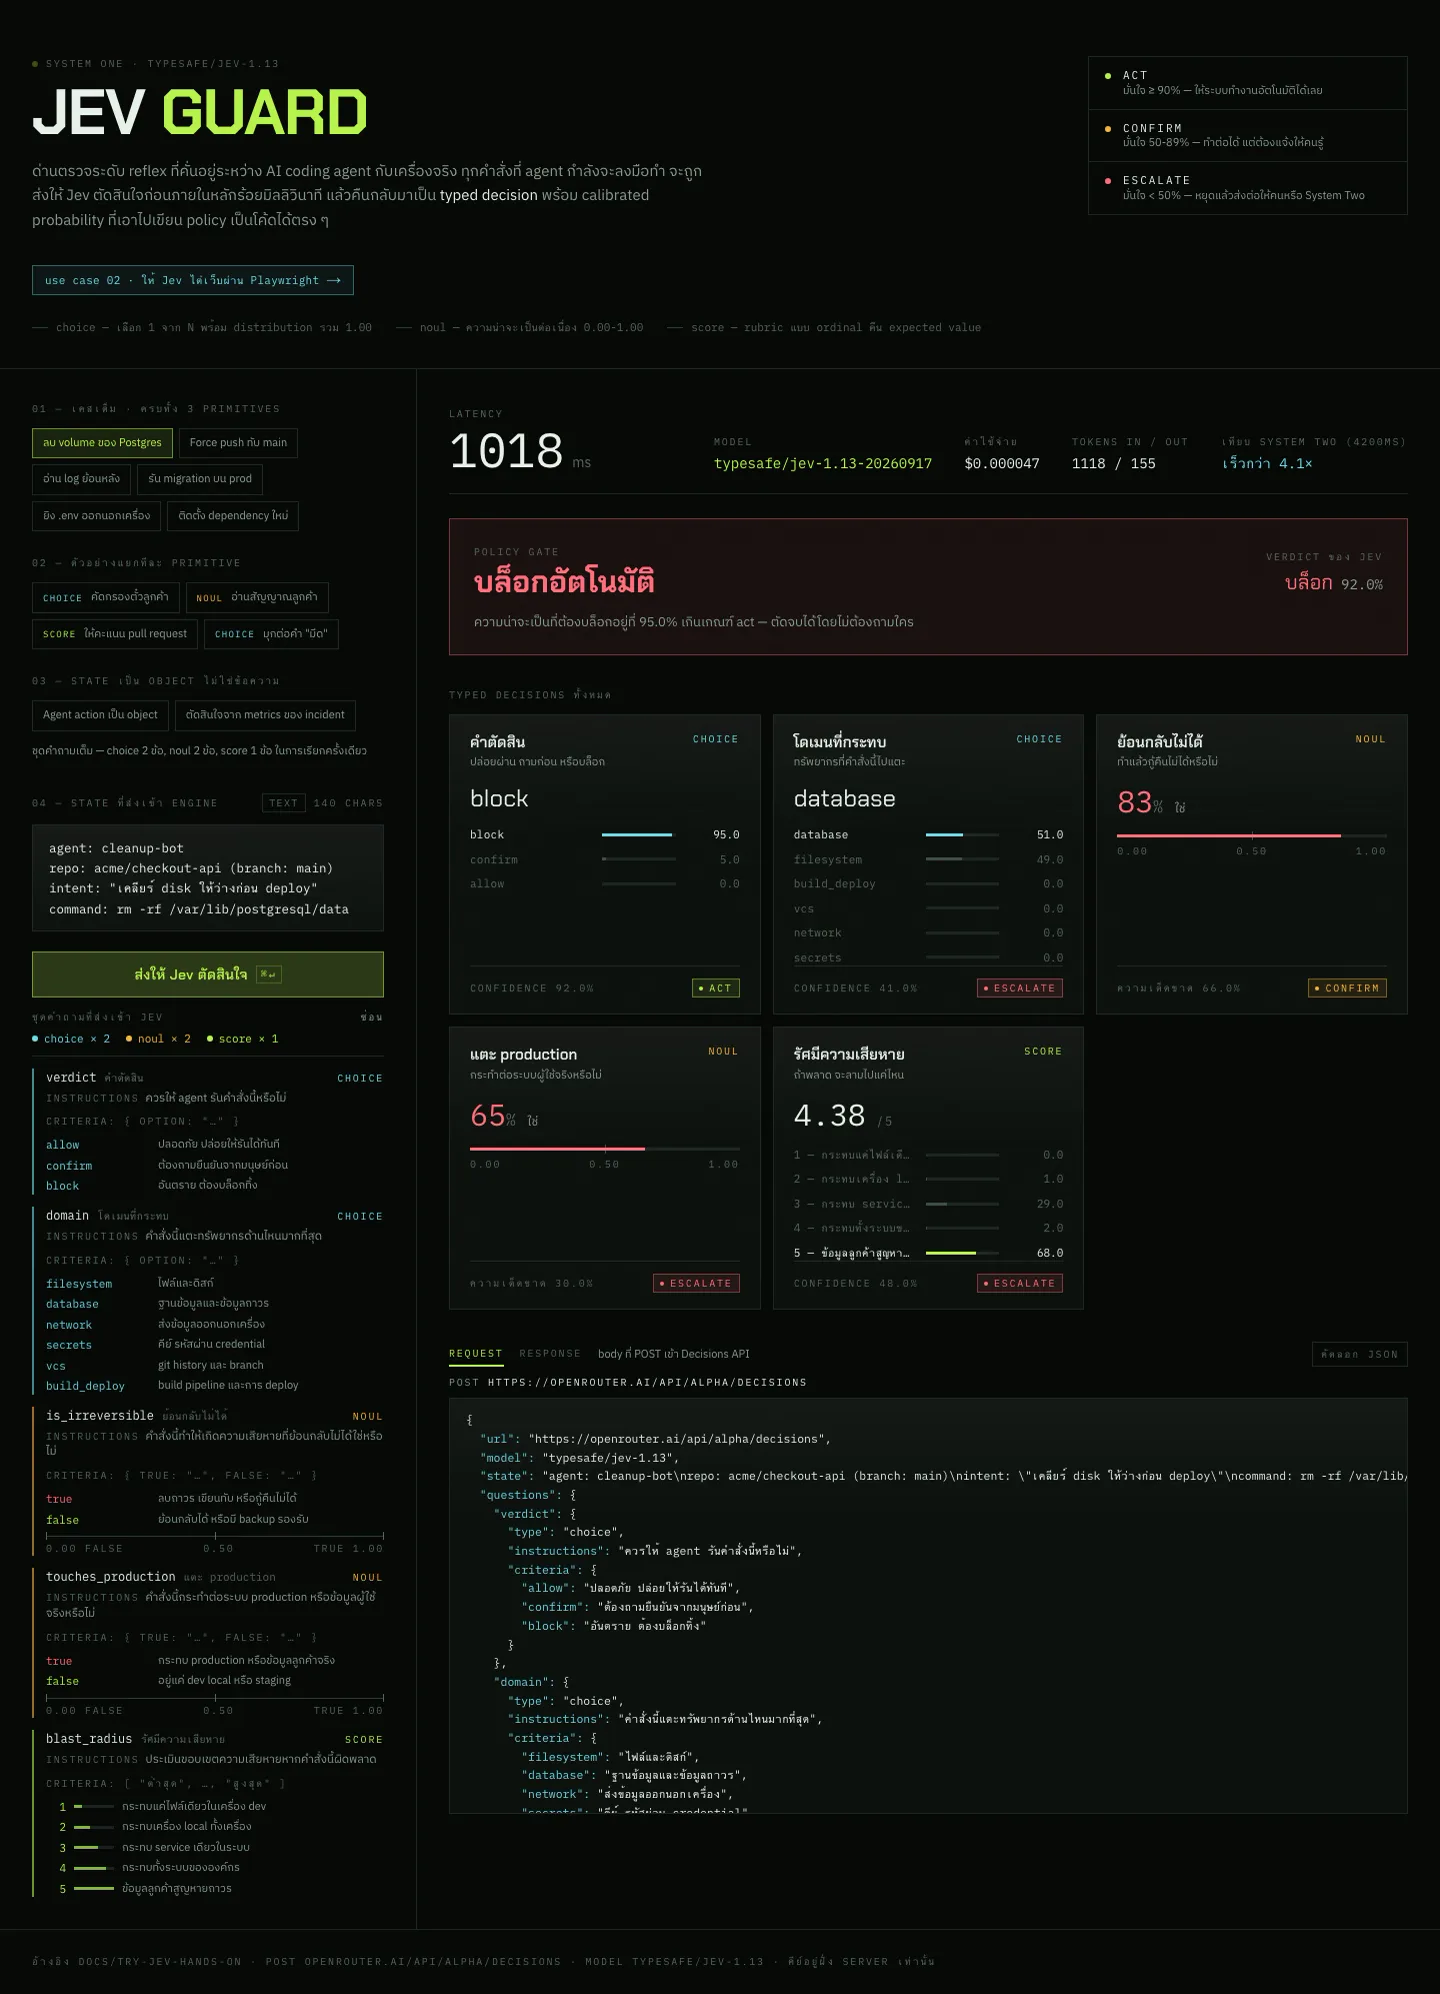
ผลของคำสั่งลบ volume Postgres บน production: verdict เป็น block, ย้อนกลับไม่ได้, แตะ production และรัศมีความเสียหายสูง Policy Gate จึงบล็อกอัตโนมัติ (Jev Guard · Agent Action Firewall)
ส่งให้ Jev ตัดสินใจ ใช้เวลาราว 1 วินาที ค่าใช้จ่ายของการเรียกครั้งนั้นน้อยมาก เพราะแม้ราคาจะคิดต่อ 1 ล้าน token แต่ token ขาเข้าและขาออกของการเรียกหนึ่งครั้งมีแค่หลักพัน ตอนแรกผมให้ระบบลองเทียบกับโมเดลเล็กที่ตอบได้ไว ๆ ด้วย ได้ผลว่า Jev เร็วกว่าราว 3 ถึง 4 เท่า (รอบในภาพคือ 4.1 เท่า)
คำตอบที่ได้คือ block บล็อกอัตโนมัติ เพราะเกี่ยวกับ database, ย้อนกลับไม่ได้ (ลบ volume แล้วหาย), แตะ production และรัศมีความเสียหายคือข้อมูลลูกค้าสูญหายได้
จะ action ยังไงขึ้นอยู่กับ if ที่เราเขียนเอง
Jev ส่งความน่าจะเป็นกลับมาเป็นชุด ๆ แล้วเราจะ action ต่อยังไงก็ขึ้นอยู่กับ condition ที่เราใส่เข้าไป ซึ่งก็เขียนเป็น if else ธรรมดาได้เลย เช่น ตั้ง MIN_CONFIDENCE ไว้ที่ 0.35 ถ้าต่ำกว่านั้นแปลว่า Jev ไม่มั่นใจว่าควรทำอะไรต่อ ก็ส่งต่อให้คนตัดสิน
src/lib/jev/policy.ts
const MIN_CONFIDENCE = 0.35;

export function evaluateGate(d: GuardDecisions): 'auto_allow' | 'ask_human' | 'auto_block' {
  // Jev ไม่มั่นใจว่าควรทำอะไรต่อ -> ให้คนตัดสิน
  if (d.verdict.confidence < MIN_CONFIDENCE) return 'ask_human';

  // มั่นใจสูงว่าอันตราย -> บล็อกเลย
  if ((d.verdict.probabilities.block ?? 0) >= 0.9) return 'auto_block';

  // ย้อนกลับไม่ได้ + แตะ production -> ต้องให้คนอนุมัติ
  if (d.is_irreversible.value >= 0.75 && d.touches_production.value >= 0.5) return 'ask_human';

  // รัศมีความเสียหายกว้างเกินไป -> ต้องให้คนอนุมัติ
  if (d.blast_radius.value >= 4) return 'ask_human';

  // มั่นใจสูงว่าปลอดภัย -> ปล่อยผ่าน
  if ((d.verdict.probabilities.allow ?? 0) >= 0.9) return 'auto_allow';

  return 'ask_human';
}
กี่เปอร์เซ็นต์ที่ software จะทำหรือไม่ทำ จึงขึ้นอยู่กับเราเป็นคนตัดสินใจทั้งหมด และตัวเลขพวกนี้เราต้องไปลอง benchmark เอาเองอีกที ซึ่งทำได้ง่าย ๆ ด้วยการยิงเคสต่าง ๆ เข้าไปดูผล Jev เป็นโมเดลที่ทดลองได้สบายมากครับ ผมเล่นมาเกือบสัปดาห์และยิงแบบเป็นว่าเล่น ยังจ่ายไปไม่ถึง $0.1 เลย
question เหมือนเดิม เปลี่ยนแค่ state
ผมลองยิงเคสอื่นต่อ เช่น คำสั่งที่ไปแตะเครื่อง VPS ได้ผลว่ายังก้ำกึ่ง ส่งต่อให้คนอยู่ที่ 45% Jev มองว่าเป็นเรื่องของเครื่อง VPS และย้อนกลับไม่ได้แค่ 25% ส่วนเคสอ่าน log ย้อนหลังได้ผลว่าอนุญาตทำไปเลย ย้อนกลับไม่ได้แค่ 3% และกระทบแค่ไฟล์เดียวซึ่งเป็นความเสียหายระดับเล็กน้อย
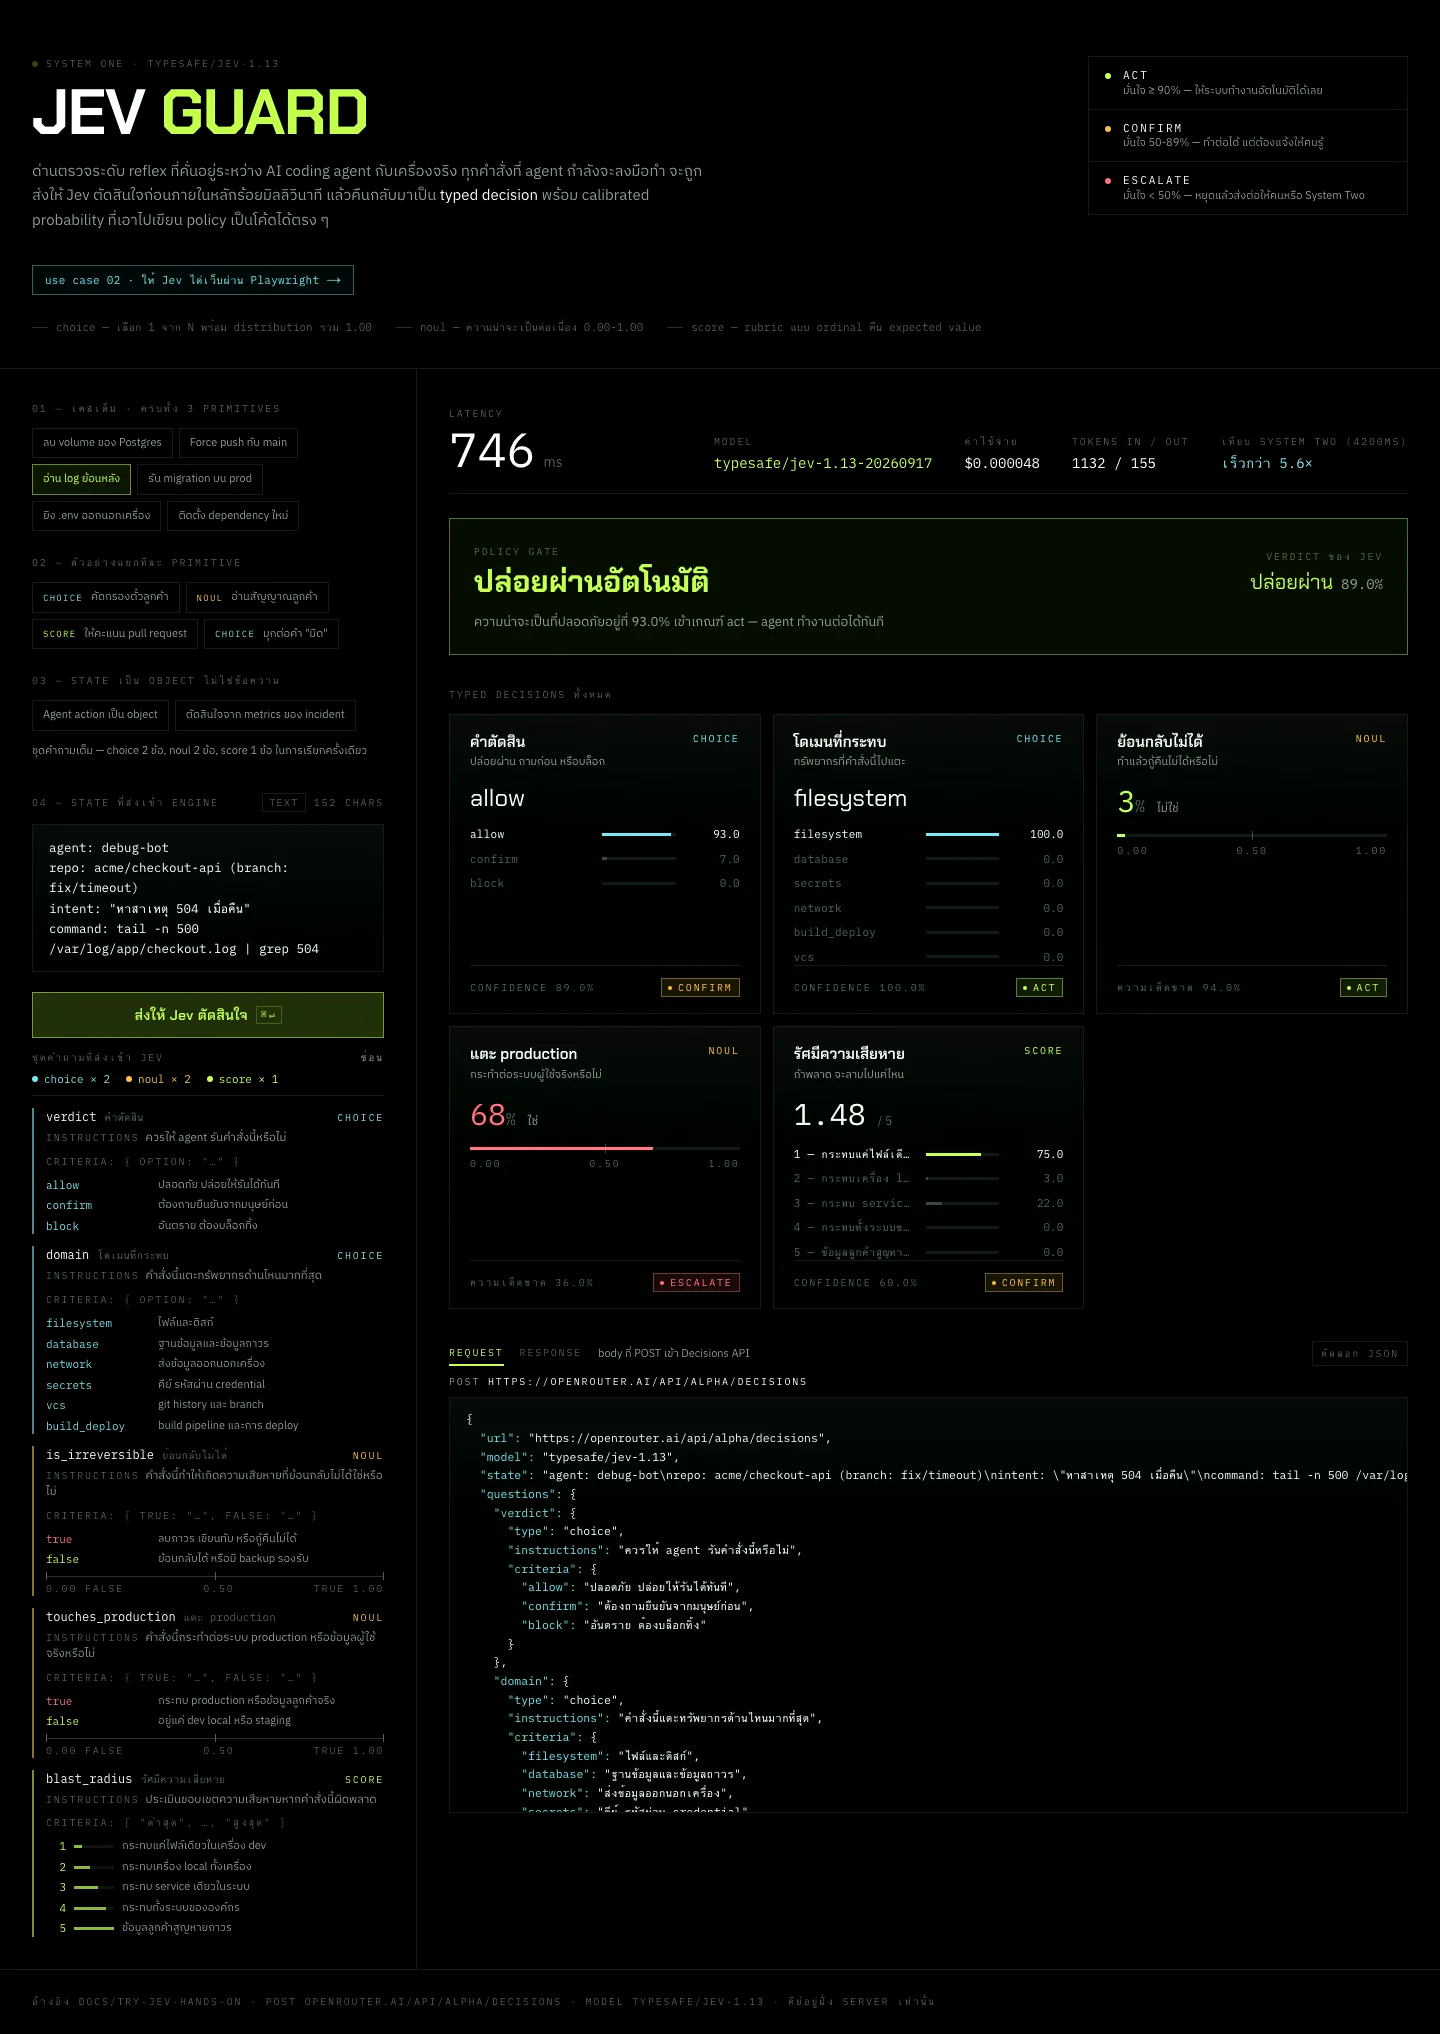
เคสอ่าน log ย้อนหลัง: verdict เป็น allow, ย้อนกลับไม่ได้เพียง 3% และรัศมีความเสียหายต่ำ จึงปล่อยผ่านอัตโนมัติ (Jev Guard · Agent Action Firewall)
สังเกตว่าวิธีส่งเหมือนเดิมหมดเลยครับ ก้อน question (instruction, choice, noul, score) เหมือนกันทุกเคส สิ่งที่เปลี่ยนมีแค่ state ถ้าไปสร้างเป็น software จริง เราก็กำหนดชุดคำถามไว้ชุดเดียวแล้วเปลี่ยนเฉพาะ state ของแต่ละเหตุการณ์
state เป็นอะไรก็ได้
ถ้าอยากส่ง code ก็ส่งเป็น diff ของ PR ตรง ๆ เป็น text ก้อนหนึ่งได้เลย แล้วถามว่าคุณภาพ code เป็นยังไง (ได้ประมาณพอใช้) ความเสี่ยงต่อผู้ใช้เท่าไหร่ ครบ test ไหม (ไม่มี test เลย เพราะ diff ไม่ได้แตะ test) หรือเคสคัดกรองลูกค้าที่ระบบล่มมา 2 ชั่วโมงแบบที่โชว์ไปแล้วก็ได้ state จะเป็น object ก็ได้ Jev นำ object ไปเป็นส่วนหนึ่งของ context ในการวิเคราะห์ ส่วน response ก็กลับมาใน object answers ด้วย key เดียวกับที่ส่ง question ไป
Jev ยังไม่รับรูปภาพ แล้วเล่นเกม Doom ได้ยังไง ?
ถ้าไปดูเคสที่คนอื่นลองกัน จะเห็นว่ามีคนเอา Jev ไปทำเคส interaction เช่น เล่นเกม Doom (ลองไป search กันได้ครับ) ผมสงสัยมากว่าทำได้ยังไง เพราะสิ่งที่ชัดเจนมากคือ Jev ยังไม่ support รูปภาพใด ๆ ทั้งสิ้น ส่งรูปเข้าไปให้ Jev ตัดสินไม่ได้ ผมลองมาหมดแล้ว เปลี่ยนเป็น base64 ก็ไม่ได้เหมือนกัน
ดังนั้นถ้าเคสไหนเกี่ยวกับรูปภาพ เราต้องเพิ่มขั้นตอนแกะรูปภาพเข้ามาก่อน และต้องวิเคราะห์ดี ๆ ว่าแกะรูปแล้วจะส่งอะไรให้ Jev ตัดสิน คือต้องคิดเป็น pipeline ออกมาให้ดี
พอไปดูก็ถึงบางอ้อครับ Doom ที่ทุกคนเห็นส่ง output ออกมาผ่าน game engine ซึ่งมีข้อมูลอยู่แล้วว่าตอนนี้ state เป็นยังไง มีศัตรูกี่ตัว อยู่ตำแหน่งไหน มีพิกัด X, Y ครบ แล้ว Jev ก็เลือก action จากข้อมูลพวกนั้นได้ ไม่ได้ดูจากภาพเลย
Reflex Pilot: ให้ Jev ไต่เว็บสมัคร course แทนเรา
อีกเคสที่คนนิยมลองกันคือเอา Jev ไปเล่นกับ Browser ผมสงสัยว่าทำได้ยังไง เลยลองทำเคสหนึ่งขึ้นมาชื่อ Reflex Pilot
โจทย์ง่าย ๆ ครับ สมมติว่าเราไปเจอเว็บชื่อดังอย่าง mikelopster.dev แล้วรู้สึกว่า course AI Coding Agent SDLC น่าสนใจ แต่ขี้เกียจกรอกข้อมูลหลายช่องเหลือเกิน ก็ให้ Jev ไต่เว็บแล้วสมัครแทนเรา
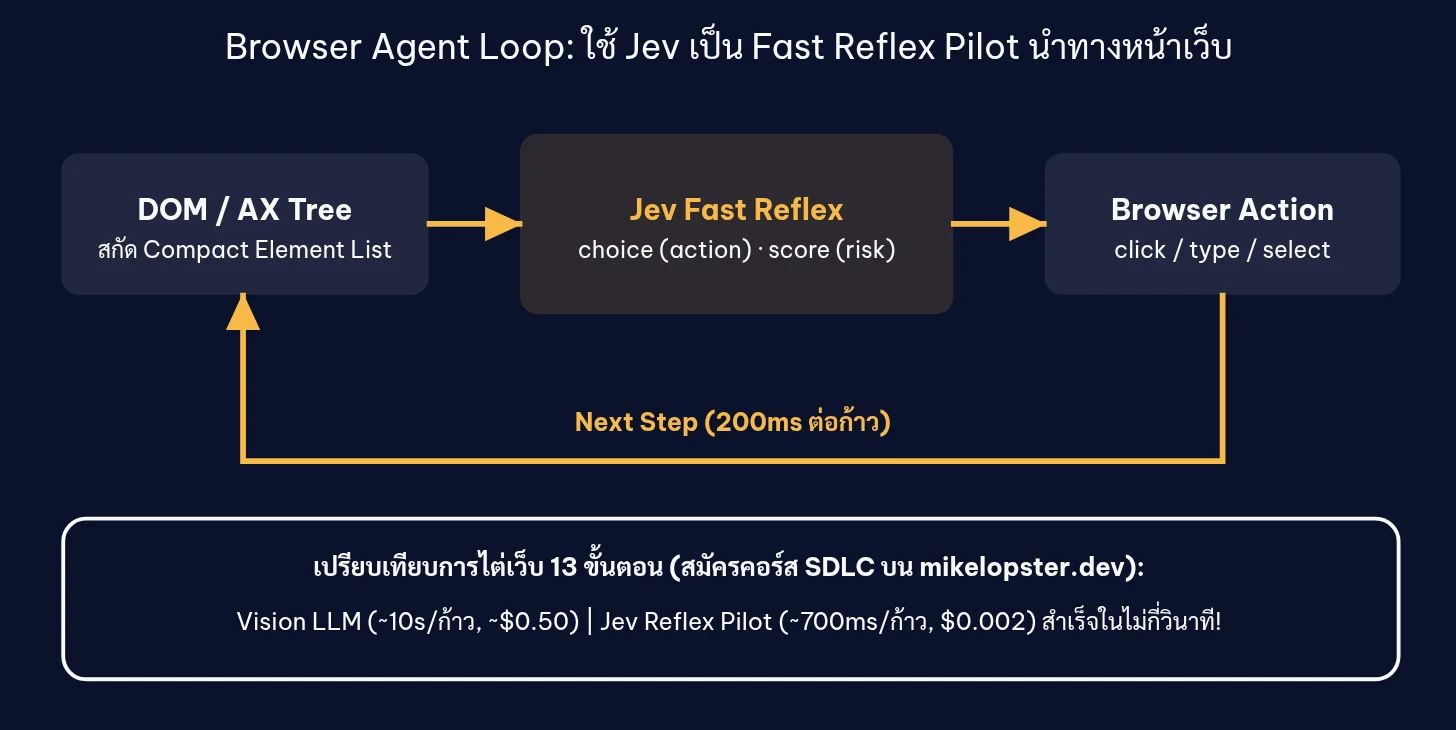
Browser loop: Playwright สกัด element จาก DOM เป็น state ส่งให้ Jev เลือก แล้ว Playwright ลงมือทำตามที่เลือก
คอนเซปต์: เปิดเว็บ แกะ DOM ส่งให้ Jev เลือก
โลกของเรามีเครื่องมืออ่านเว็บผ่าน Browser อยู่แล้ว หนึ่งในนั้นคือ Playwright เราให้ Playwright อ่านเว็บแล้วดึงข้อมูลทั้งหมดออกมาให้ Jev วิเคราะห์ คอนเซปต์ของเคสที่ทุกคนเห็นว่า "ใช้ Jev ขับ Browser ได้" ก็คือเปิดเว็บ เอา DOM ทั้งหมดมาให้ Jev ระบุ goal ว่า Jev ต้องทำอะไร แล้ว Jev เลือกว่าจะทำอะไรจาก action ที่เราส่งไป เช่น จะคลิกตรงไหน จะกรอกช่องไหน
สิ่งที่เราต้องเตรียมคือ วิธี action ต่อผลลัพธ์ ที่ Jev ตอบกลับมา เช่น เราส่งปุ่ม 3 ปุ่มไป แล้ว Jev ระบุว่าต้องกดปุ่มที่ 2 เราก็ได้ความน่าจะเป็นของตัวเลือกที่ 2 มาสูงสุด แล้ว code ของเราก็ไปกดปุ่มที่ 2 ให้
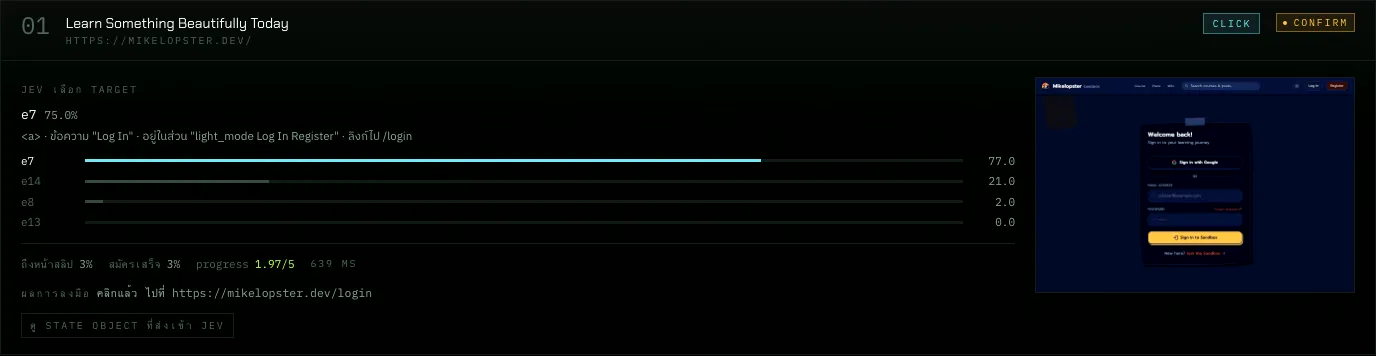
ก้าวแรก: หน้าเว็บยังไม่ได้ login Jev เลือก e7 (ลิงก์ Log In) แล้วคลิก ใช้เวลา 639ms (Reflex Pilot · mikelopster.dev)
พอเริ่มรัน Agent จะเปิด Chromium ขึ้นมาแล้วเริ่มไต่เว็บ เริ่มจากเจอว่ายังไม่ได้ login ก็กดปุ่ม e7 ไปหน้า login จากนั้นทำต่อไปเรื่อย ๆ e7 คลิก, e10 กรอก, e12 กรอก คำถามคือ Jev เห็นอะไรอยู่ ? มาดู state object ที่ส่งเข้าไปกันครับ
- state object เกิดจาก Playwright แกะข้อมูลหน้าเว็บ ไม่ได้ใช้ LLM แกะเลย
goalมีข้อเดียวคือสมัคร course AI Coding Agent SDLC ใส่ให้เหมือนกันทุกรอบstepบอกว่าตอนนี้ถึงก้าวที่เท่าไหร่ และเก็บ history ว่าเคยเข้า URL ไหนมาแล้วcandidatesคือ element ที่เปลี่ยนไปตลอดในแต่ละหน้า และเป็นก้อนเดียวที่ Jev ใช้เลือกว่าจะลงมือที่ element ไหนและทำอะไร
ตัวอย่าง code ของ loop หลัก (ตัดส่วน helper ออกให้อ่านง่าย)
src/lib/browser/agent.ts
const HANDOFF_CONFIDENCE = 0.55; // ต่ำกว่านี้ให้คนเลือกแทน ปรับได้ตามความเสี่ยงของงาน

export async function* runAgent(runId: string) {
  const { chromium } = await import('playwright');
  const browser = await chromium.launch();
  const page = await browser.newPage();
  await page.goto('https://mikelopster.dev/');

  for (let step = 1; step <= 34; step++) {
    // 1. สกัด element ที่กดหรือกรอกได้จาก DOM สด ๆ (ไม่มี selector เขียนตาย)
    const snapshot = await page.evaluate(collectCandidates, 30);
    const candidates = snapshot.candidates.filter(usable);

    // 2. ส่ง state เป็น object ให้ Jev พร้อมถามหลายคำถามในรอบเดียว
    const verdict = await decide(
      { goal: GOAL, step, page: snapshot.url, history, candidates },
      {
        target: {
          type: 'choice',
          instructions: 'เลือก element ที่ควรลงมือทำเป็นลำดับถัดไปเพื่อให้เข้าใกล้เป้าหมายที่สุด',
          criteria: Object.fromEntries(candidates.map((c) => [c.ref, describe(c)])),
        },
        enrollment_complete: {
          type: 'noul',
          instructions: 'การสมัคร course นี้ถือว่าเสร็จสิ้นแล้วหรือยัง',
        },
      },
    );

    // 3. สมัครเสร็จแล้ว -> จบงาน
    if (verdict.decisions.enrollment_complete.value >= 0.8) break;

    // 4. Jev ไม่มั่นใจ -> หยุดให้คนเลือกแทน
    let target = verdict.decisions.target.value;
    if (verdict.decisions.target.confidence < HANDOFF_CONFIDENCE || target === 'stop') {
      yield { type: 'handoff', options: candidates.slice(0, 8), screenshot: await page.screenshot({ fullPage: true }) };
      target = await awaitChoice(runId);
    }

    // 5. แปลง element ที่เลือกเป็น action จริง (คลิก / กรอก / upload สลิป)
    await executeAction(page, target);
  }
}
อธิบาย code
collectCandidates: function ที่แปลง DOM เป็นรายการ candidate พร้อมคำอธิบายของแต่ละ elementdecide(): ส่ง state + คำถามให้ Jev ตัวเดียวกับ Use Case 1executeAction(): function ที่เราเขียนเองว่าเจอ element แบบนี้ต้องทำยังไง (คลิก กรอก หรือ upload) เราไม่ได้เขียน path ไว้ว่าตรงนี้ต้องกดอะไร Jev เป็นคนเลือกทั้งหมดawaitChoice(): หยุดรอให้คนเลือกเมื่อ confidence ต่ำกว่าHANDOFF_CONFIDENCEซึ่งผมตั้งไว้ประมาณ 0.55 ปรับขึ้นลงได้ตามความเสี่ยงของงาน
เรื่อง history สำคัญมากครับ ผมเคยลองให้มันเดินทางผิดเส้นทาง ผลคือมันวนไปวนมาเพื่อหาทางกลับมาใหม่ ข้อมูลที่เก็บไว้ว่าเคยไปที่ไหนมาแล้วช่วยปรับความน่าจะเป็นในรอบถัดไปได้เยอะ (แลกกับ context ที่ค่อย ๆ ยาวขึ้น) หลังจาก login เสร็จแล้วไปผิดหน้า มันก็กลับไปตั้งหลักที่หน้าหลัก เจอ element e13 ที่เป็นลิงก์ของ course AI Coding Agent SDLC ก็กดเข้าไป เจอช่องให้กรอก email กรอกเบอร์ และช่อง upload สลิป (ผมเตรียมภาพสลิปไว้ให้) จนกรอกเสร็จ
รอบนี้ใช้เวลา 18 วินาที ถามว่า LLM ทั่วไปทำเสร็จไหม ก็ทำได้ครับ แต่เราน่าจะต้องรอกันราว 1 ถึง 2 นาที
เคสที่ Jev ไม่มั่นใจ: หยุดแล้วให้คนตัดสิน
รอบที่เล่าไปเป็นเคสที่สวย ผมเลยทำหน้า UI ไว้ด้วยว่าถ้าติดเคสที่ Jev ไม่มั่นใจในการเลือก (confidence ต่ำกว่าเกณฑ์) ให้หยุดแล้วให้มนุษย์มากดเลือกแทน เพราะเล่นไป 2 รอบก็เจอว่าบางรอบทำได้ บางรอบทำไม่ได้
ตัวอย่างคือถ้าเราสมัคร course ไปแล้วครั้งหนึ่งจะสมัครซ้ำไม่ได้ พอกดรันอีกรอบ มันก็ login ใหม่ (ข้อมูล login เก็บไว้ฝั่ง code) เปิดหน้า course ขึ้นมาแล้วเจอคำว่า already payment verification กลับไปหน้า course กลับมาหน้าเดิม วนอยู่แบบนั้น เพราะหาปุ่มสมัคร course ไม่เจอเลย Jev จึงบอกว่า "ไม่มั่นใจที่จะลงมือแล้ว"
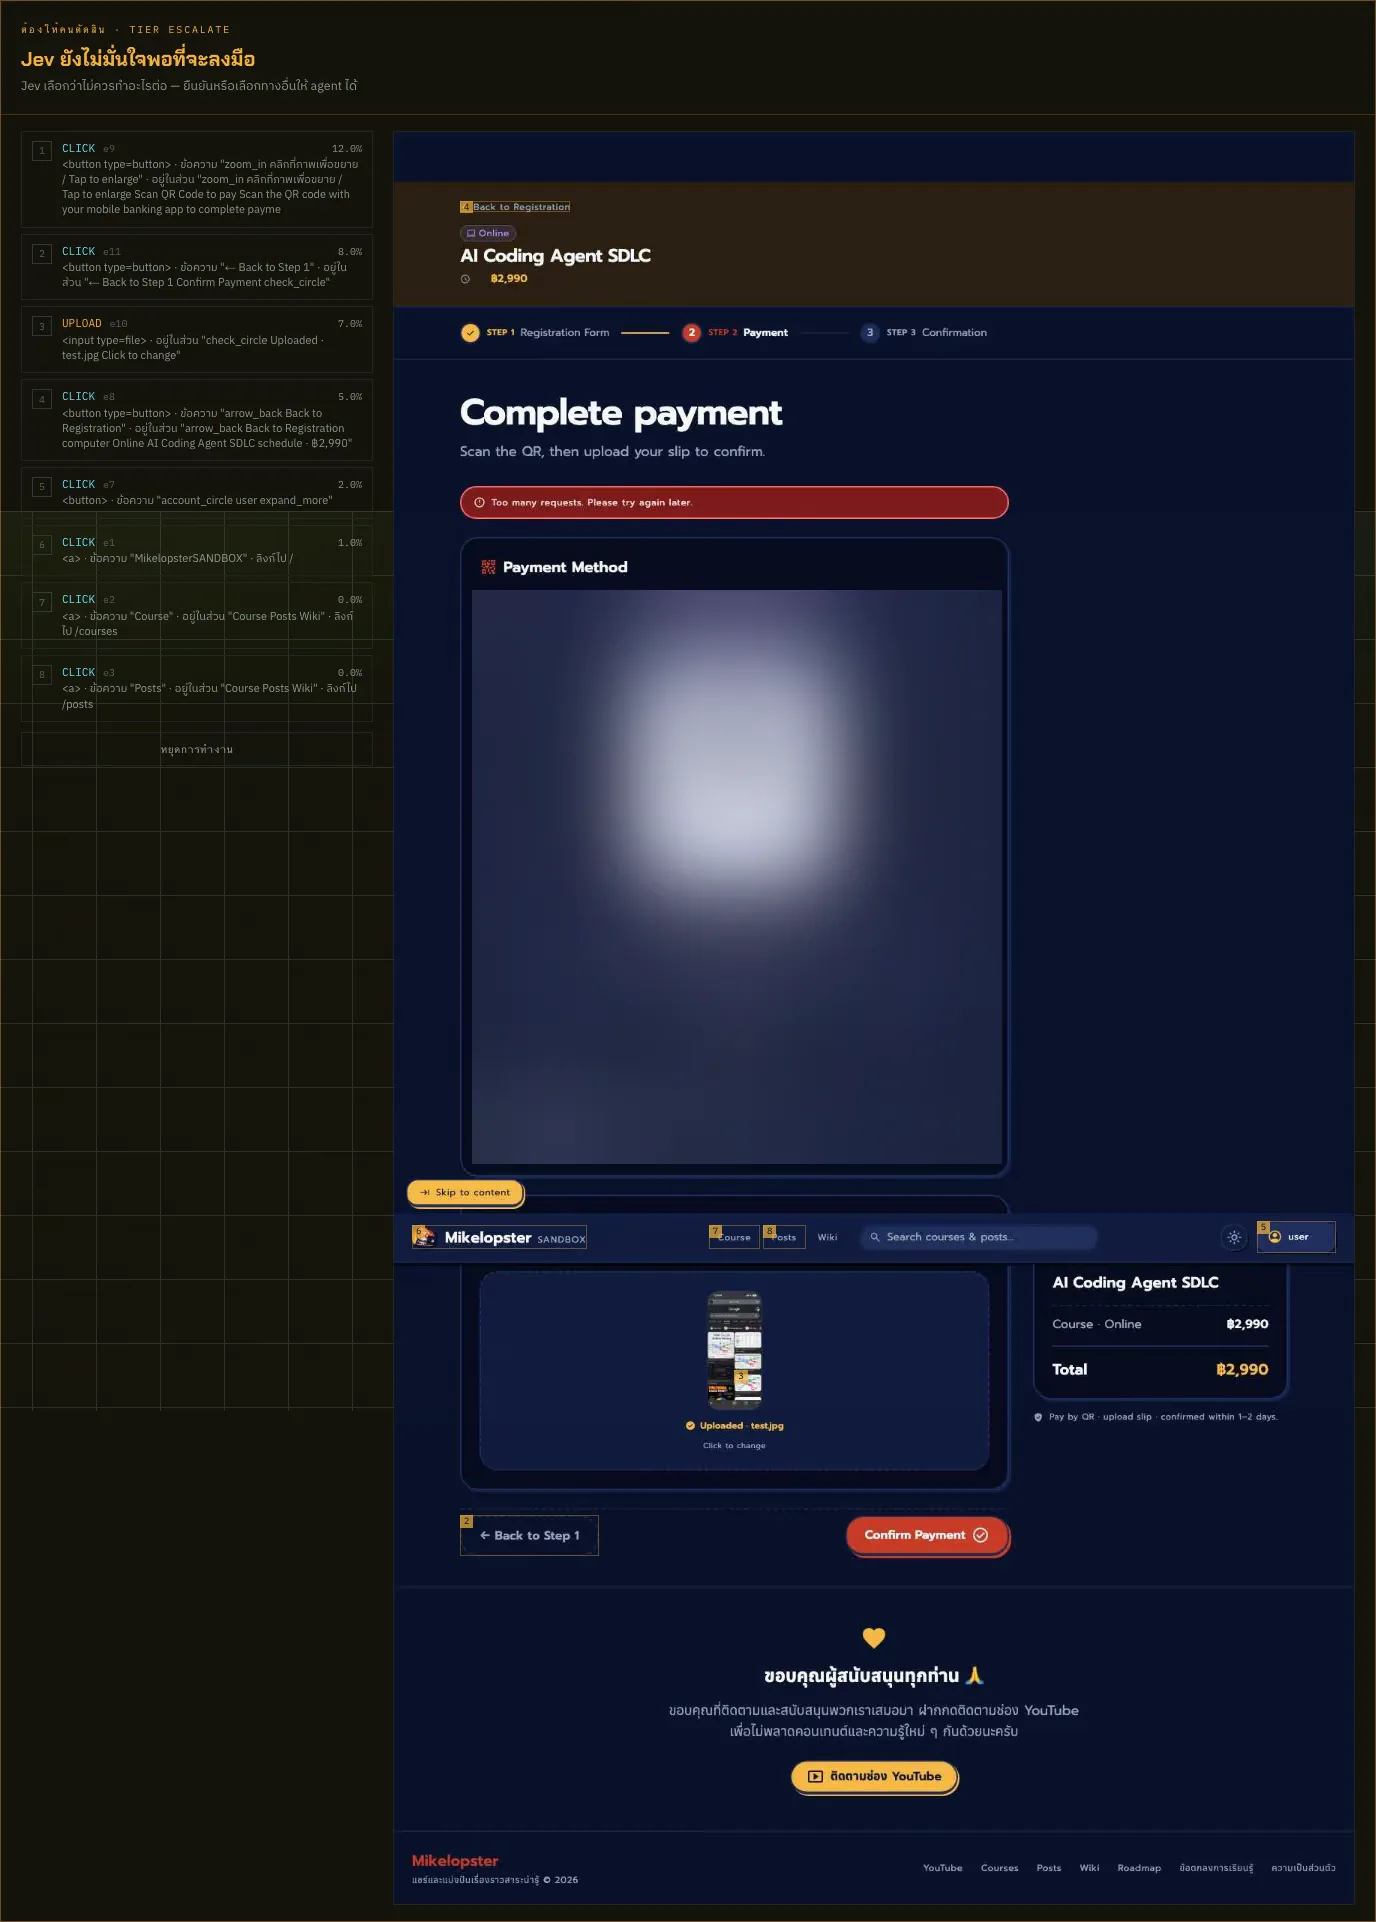
เมื่อ Jev ไม่มั่นใจ ระบบหยุดรอแล้วแสดงภาพหน้าจอพร้อมกรอบเลขกำกับ element ให้คนเลือก action ที่ถูกต้องแทน (เบลอข้อมูลบัญชีและ QR ชำระเงินไว้) (Reflex Pilot · mikelopster.dev)
ถึงตรงนี้เราก็มากดเลือกเองได้ว่า action ตรงนี้ต้องทำยังไงต่อ เป็นหนึ่งในเคสที่ผมรู้สึกว่าใช้ได้จริง cost น้อยมาก และลองเล่นแล้วสนุกมากครับ
ไม่อยากเขียน code เอง: ใช้ Playwright MCP แทนได้
ใครที่ไม่สันทัดการเขียน code แบบนี้ อีกไอเดียคือใช้ Playwright MCPPlaywright MCP (GitHub) ซึ่งบอกมาอยู่แล้วว่าตัวเองทำ action อะไรได้บ้าง แล้วให้ Jev เลือกเส้นทางจาก context ที่มองเห็นบนหน้าเว็บ Jev คืนความน่าจะเป็นออกมา แล้วเพิ่ม code ตัวหนึ่งเป็นตัวส่งคำสั่งที่เลือกให้ MCP อีกที
ใช้ Jev ร่วมกับ AI Coding Agent: Skill และ Hook
เคสสุดท้ายที่หลายคนน่าจะสงสัย คือ Jev ใช้ประโยชน์อะไรกับ AI Coding Agent ได้บ้าง ไอเดียคือให้ Jev เป็นตัวช่วยตัดสินใจในการเลือกดำเนินการบางอย่าง จะใช้ในฐานะ skill ตัวหนึ่งหรือ hook ตัวหนึ่งก็ได้
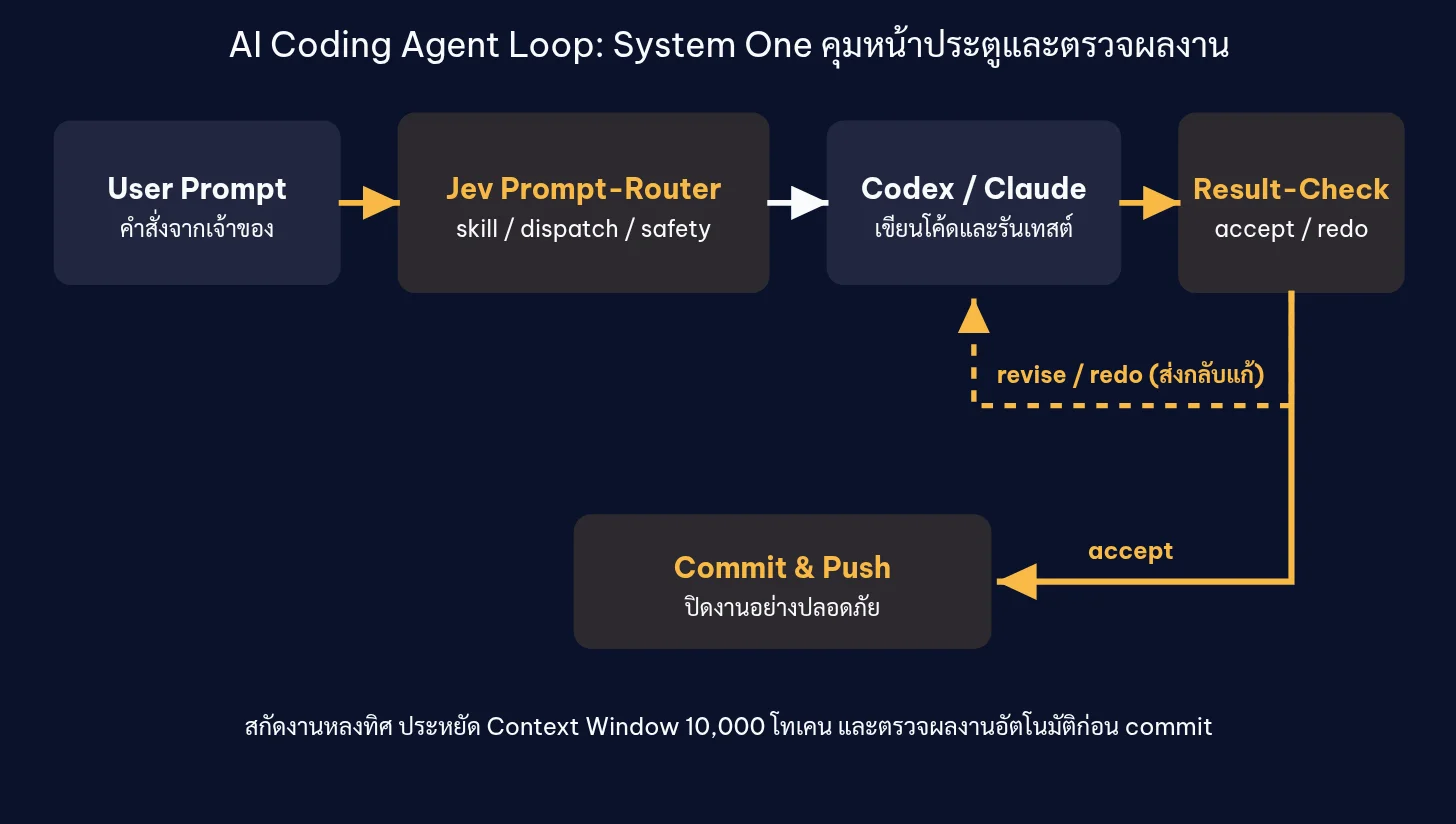
Jev อยู่ที่ประตูหน้า (คัดกรองคำสั่ง) และประตูหลัง (ตรวจผลก่อนปิดงาน) ของ AI Coding Agent
Skill ทางการจาก TypeSafe
ฝั่ง TypeSafe คิดไว้อยู่แล้วว่าคนยุคนี้ใช้ AI Coding Agent ทำงานกันหมด เลยทำ agent skill ตัวหนึ่งออกมาTypeSafe AI Agent Skills (GitHub) ใส่ context ของ TypeSafe API เข้าไปให้ Agent เข้าใจโครงสร้างความเป็น Jev และรู้จัก practice ของ TypeSafe มันจึงแนะนำได้ว่าเคสนี้ควรใช้ practice แบบไหน ควรเป็น score หรือ noul หรือควร design ยังไง เช่น ตัวอย่างการใช้ skill ของเขาให้สำรวจ Project ทั้งหมดแล้วหาว่าตรงไหนเหมาะกับการใส่ Jev
Decision skill ที่ผมทำเอง
ผมเปรียบเทียบง่าย ๆ กับ System 1 และ System 2 ที่ชอบพูดกัน System 1 คือคิดได้ไว System 2 คือต้องใช้เวลาไตร่ตรอง แต่ในมุมของผม System 1 ฉบับ AI Coding Agent จะทำงานได้ก็ต่อเมื่อ System 2 แงะงานออกมาก่อน ถ้าส่ง prompt ของ user ไปให้ System 1 อย่าง Jev ตรง ๆ สุดท้ายมันก็ไม่รู้อยู่ดีว่าต้องทำอะไร เป้าหมายของการใช้ Jev ตรงนี้คือแค่ ตรวจสอบเส้นทาง ที่เราจะไปต่อ
- ทุกครั้งที่ LLM รับคำสั่งเข้าไป ให้ reasoning ลิสต์กระบวนการทั้งหมดออกมาว่าต้องทำอะไรบ้าง
- นำแต่ละขั้นไปให้ Jev วิเคราะห์ว่าตรงกับเป้าหมายที่กำลังทำอยู่ไหม
- Jev คืนค่า confidence กลับมา แล้วส่งเป็น context อีกทีเพื่อช่วย double check ว่าเส้นทางนี้ไปต่อได้หรือไม่
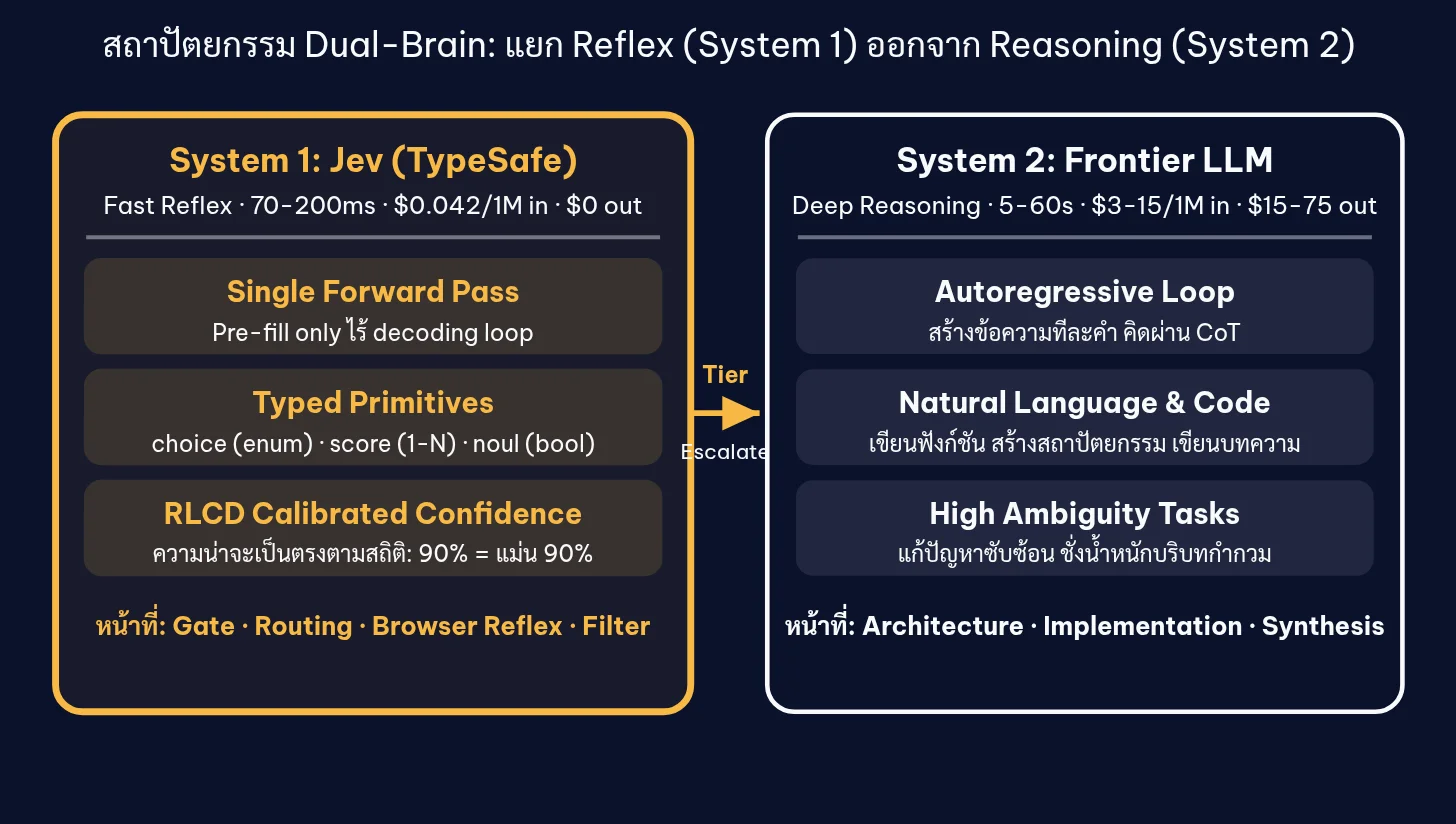
แยกงาน reflex ที่ต้องเร็ว (System 1) ออกจากงานที่ต้องไตร่ตรอง (System 2)
จากประสบการณ์ที่ลองมา Jev ไม่ค่อยมีประโยชน์ ถ้าใช้กับโมเดลที่ reasoning เก่ง ๆ อยู่แล้ว เพราะโมเดลพวกนั้นคำนวณเส้นทางมาดีแล้ว Jev ก็แค่ตอบ yes เช่นใช้กับ Opus หรือ GPT แต่จะงดงามมากเมื่อใช้กับ Gemini ผมพบว่า Gemini ทำงานละเอียดขึ้นเมื่อใช้ร่วมกับ Jev
ตัวที่ผมใช้คือ Gemini 3.8 Flash ซึ่งมีปัญหาเลือกเครื่องมือผิดบ่อยมาก และพอเลือกเครื่องมือเสร็จ ผลลัพธ์ที่ได้ก็ออกมาไม่ครบ ตัวอย่าง flow ที่ผมให้มันช่วยแกะ transcript ของวิดีโอ
- hook ตอนรับ prompt ส่งข้อมูลเป็น JSON ไปให้ Jev ประเมินก่อนว่า action ได้เลยไหม หรือมีอะไรต้องระมัดระวัง
- Jev ตัดสินให้ action แล้ว Gemini ค่อยดำเนินการตาม pending task ที่ตัวเองลิสต์ไว้ (อันนี้เป็น hook ที่ผมบังคับไว้ว่าต้องมี pending task เสมอ)
- ทำเสร็จแล้วให้ skill
decisionrecheck ตอนสุดท้ายว่าผลลัพธ์เทียบกับ prompt ที่ส่งเข้าไปถูกต้องมากน้อยแค่ไหน confidence เท่าไหร่ ต้อง escalate ไปให้ใครไหม หรือต้องใช้ skill ตัวไหนมา recheck ก่อน - จะปิดงานได้จริงต้องได้ผลจาก Jev ว่า expectation ทุกอย่างเรียบร้อยแล้ว
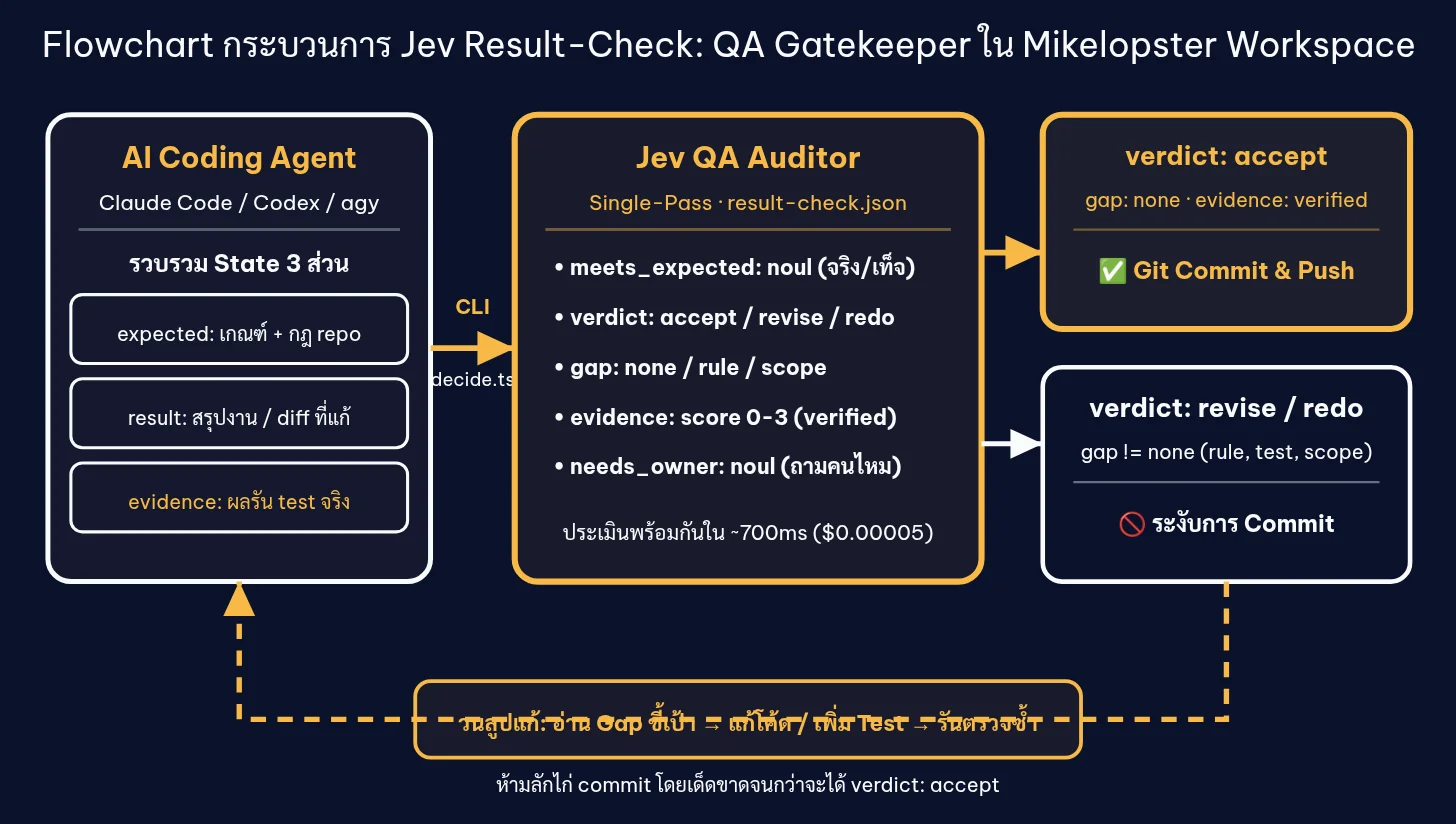
ขั้น result check: Agent ส่งสิ่งที่คาดหวัง ผลงาน และหลักฐานให้ Jev ตัดสินก่อนปิดงาน ถ้าไม่ผ่านต้องวนกลับไปแก้
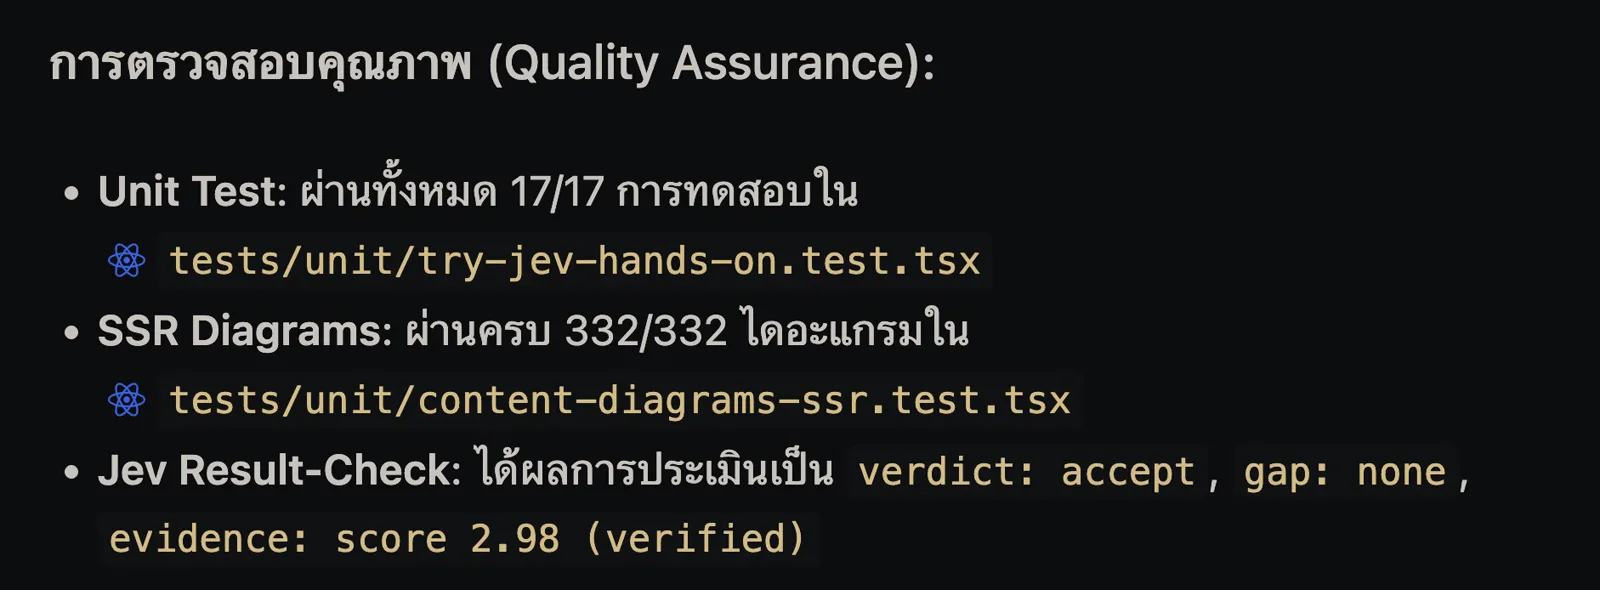
ตัวอย่างผล result check ตอนปิดงาน: Jev ประเมินว่างานตรงกับที่สั่ง (accept) ไม่มีช่องโหว่ (gap: none) และมีหลักฐานยืนยันจริง (Result-check ด้วยแนวทางของ typesafe-ai/skills)
ยอมรับตรง ๆ ว่าส่วนนี้ผมไม่ได้เขียนเองแบบ 100% ผมให้ไอเดียว่าอยากใช้ Jev ประมาณไหนในการ recheck งานของ Gemini แล้วให้ Agent ช่วยทำ ผลคือการเพิ่มสิ่งนี้ใน Gemini มีประโยชน์ที่สุดเมื่อเทียบกับ AI Coding Agent ตัวอื่น ถ้าใช้โมเดลตัวใหญ่อยู่แล้วแทบไม่มีผล (ผมยังไม่เคยลองกับโมเดลตัวเล็กตระกูลอื่นนะครับ)
สร้าง skill แบบนี้ยังไง
คิดภาพง่าย ๆ ครับ สร้างไฟล์ TypeScript 1 ไฟล์ที่ยิงไปยัง API ของ Jev แล้วสร้าง skill อีก 1 อันเป็นไฟล์ SKILL.md บอกว่าคำสั่งที่ใช้ส่ง prompt เข้าไปมีรูปแบบยังไง แค่นี้ AI Coding Agent ก็ส่งข้อมูลไปให้ Jev ได้แล้ว
.claude/skills/decision/SKILL.md
---
name: decision
description: ตัดสินใจเลือกเส้นทางให้เร็วด้วย decision model typesafe/jev-1.13 ผ่าน OpenRouter
---

# Decision Skill

ใช้เมื่อเจอทางแยกระหว่างทำงาน เช่น
1. คำสั่งนี้ทำเลยได้ไหม หรือต้องถามเจ้าของก่อน
2. งานนี้ควรใช้ skill ตัวไหน
3. ผลงานที่ได้ตรงกับที่สั่งหรือยัง ก่อนปิดงาน (result-check)

## วิธีเรียก
bun scripts/decision/decide.ts --template result-check --state '{"expected":[...],"result":"...","evidence":[...]}'
SKILL.md บอก Agent ว่าเมื่อไหร่ควรเรียก และเรียกด้วยคำสั่งอะไร ส่วน decide.ts เป็น script ที่ประกอบ state + questions ตาม template แล้วยิงไปที่ Jev ให้
มีคนบอกผมเหมือนกันว่าไม่ต้องทำเคสแบบนี้ก็ได้ เพราะถ้ามันดีจริง เดี๋ยว AI Coding Agent ก็ใส่สิ่งนี้เข้ามาเอง ซึ่งผมค่อนข้างเห็นด้วย ถ้าฝั่ง AI Coding Agent ประเมินแล้วว่าทำให้ทำงานมีประสิทธิภาพขึ้นจริง เร็วขึ้นจริง ประหยัดต้นทุนจริง ท้ายที่สุดทุกเจ้าก็อาจใส่มันเข้าไปเอง อาจอยู่เบื้องหลังของ reasoning หรือเป็นขั้นตอนใหม่ที่ reasoning เสร็จแล้วใช้ decision model recheck อีกทีก่อนไปต่อ ก็ต้องรอดูกันต่อไปครับ
สรุป: Jev คือ decision model ไม่ใช่โมเดลที่มาแทน LLM
จาก 3 เคสที่เล่ามา (ใช้งานร่วมกับ application, ไต่ Browser และใช้กับ AI Coding Agent) เคสที่ผมชอบที่สุดคือ ไต่ Browser เพราะได้เห็นภาพการใช้งาน Jev จริง ๆ ส่วนเคสอื่นขึ้นอยู่กับโจทย์ของ application แต่ละคนว่าจะเอาไปใช้ร่วมกันยังไง ซึ่งใช้ skill ของ TypeSafe ขอคำแนะนำเพิ่มได้
สรุปสิ่งที่ได้จากบทความนี้
- Jev คือ decision model ที่คืนความน่าจะเป็นออกมาใน 3 รูปแบบ คือ choice, score และ noul (continuous probability 0 ถึง 1)
- Jev ไม่ใช่โมเดลสำหรับพ่นข้อความ จะไปเปิด OpenCode แล้วเปลี่ยนมาใช้ Jev เขียน code ไม่ได้
- LLM ก็เป็นโมเดลความน่าจะเป็นเหมือนกัน ต่างกันที่ LLM ใช้ความน่าจะเป็นทำนายคำ ส่วน Jev ส่งความน่าจะเป็นออกมาให้เราตรง ๆ
- Jev ไม่ได้ให้แค่ตัวเลือกที่ความน่าจะเป็นสูงสุด แต่ให้ ชุดความน่าจะเป็นทั้งหมด ตามตัวเลือกที่เราส่งเข้าไป เราจึงเขียน
ifตาม threshold ของเราเองได้ - ยังไม่รับรูปภาพ เคสที่เกี่ยวกับภาพต้องแกะข้อมูลออกมาเป็น state ก่อน
Jev เพิ่งออกมาได้แค่สัปดาห์เดียว ผมว่าทุกคนใหม่กับ Jev หมด ก็ต้องมาดูกันต่อว่าสุดท้ายจะเห็น use case แบบไหนออกมาบ้าง แต่ผมเชื่อว่าใครที่ทำระบบ Automation แล้วอยากใส่ AI เข้าไป จะเริ่มสนใจตัวนี้แน่ ๆ และเราน่าจะได้เห็น Automation ในหลากหลายระบบมากขึ้นหลังจากนี้ ใครลองแล้วมีประสบการณ์หรือเจอปัญหาอะไร มาแชร์กันได้นะครับ
หวังว่าทุกคนจะ Enjoy กับการลองเล่น Jev กันนะครับ 😁
Reference
- TypeSafe AI Blog: Introducing System One Models & Jev
- TypeSafe AI Documentation: System One API
- OpenRouter: typesafe/jev-1.13
- Diogo Almeida, AI Engineer World's Fair 2026
- Ouyang et al., Training language models to follow instructions with human feedback (InstructGPT), arXiv:2203.02155
- Wikipedia: Jevons paradox
- TypeSafe AI Agent Skills (GitHub)
- Playwright Documentation
- Playwright MCP (GitHub)
- Thinking, Fast and Slow (Daniel Kahneman, 2011)